上周,OpenAI 发布了 GPT-5.6 系列,推出了 Sol、Terra 和 Luna 三款模型。在发布直播中,团队重点展示了计算机使用能力,展示了能够导航和操作桌面应用的模型。OpenAI 重点介绍了 UI 智能体和详细的 3D 可视化,但这两者都依赖于更强的视觉理解能力。
为了衡量它们的视觉能力,我们在即将推出的 VLM 基准测试上运行了这些模型,该基准测试计划在未来几周内发布。该基准涵盖了常见视觉任务,包括检测、计数、OCR 和数据提取。在本文中,我们仔细研究了 GPT-5.6 在各项任务中的表现。
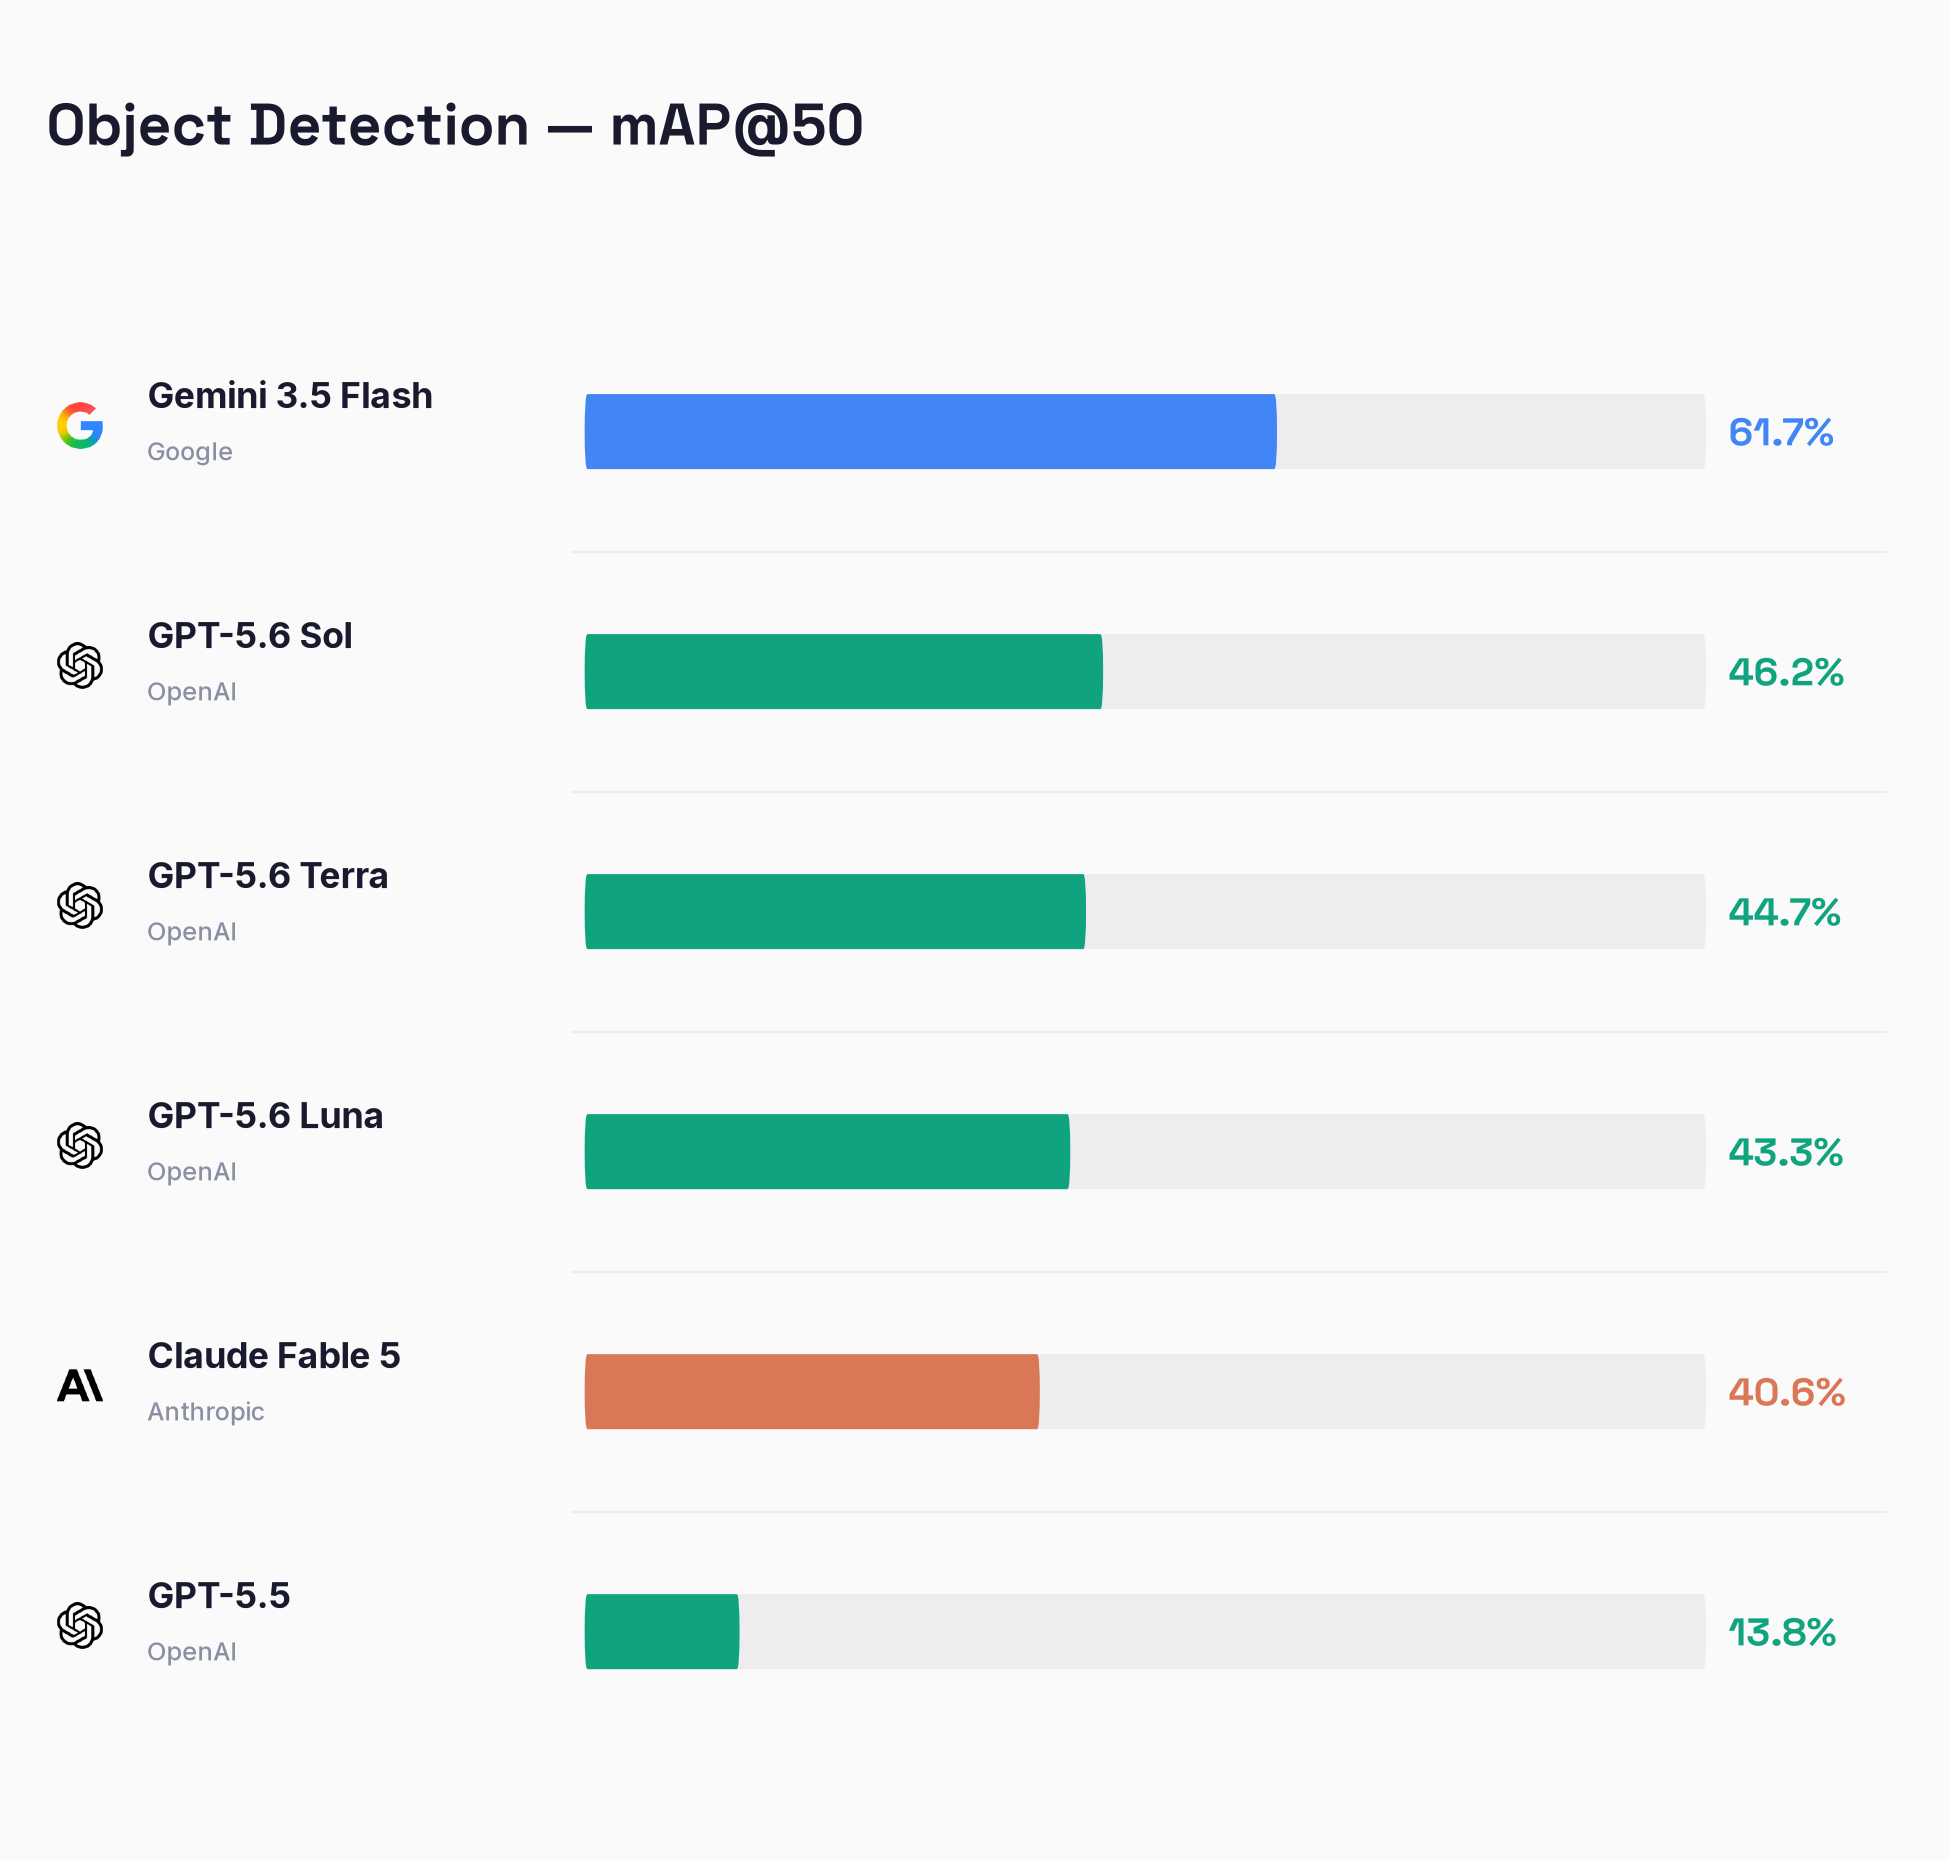
Sol 显然是 OpenAI 目前发布的最强视觉模型。提升在目标检测和计数方面尤为明显,GPT-5.5 远远落后于最强的 VLM。Terra 和 Luna 不如 Sol 强大,但相比 GPT-5.5 都取得了有意义的进步。
开始使用
在 Roboflow Playground 中测试 Sol、Terra 和 Luna,并与 Claude Fable 5、Gemini 3.5 Flash 等模型在相同视觉任务上进行比较。
目标检测
检测是 GPT-5.6 提升最明显的领域。在我们的基准测试中,GPT-5.5 的 mAP@50 得分为 13.8,而 Sol 达到了 46.2。Terra 和 Luna 紧随其后,分别为 44.7 和 43.3,将目标检测从主要弱点转变为实用能力。
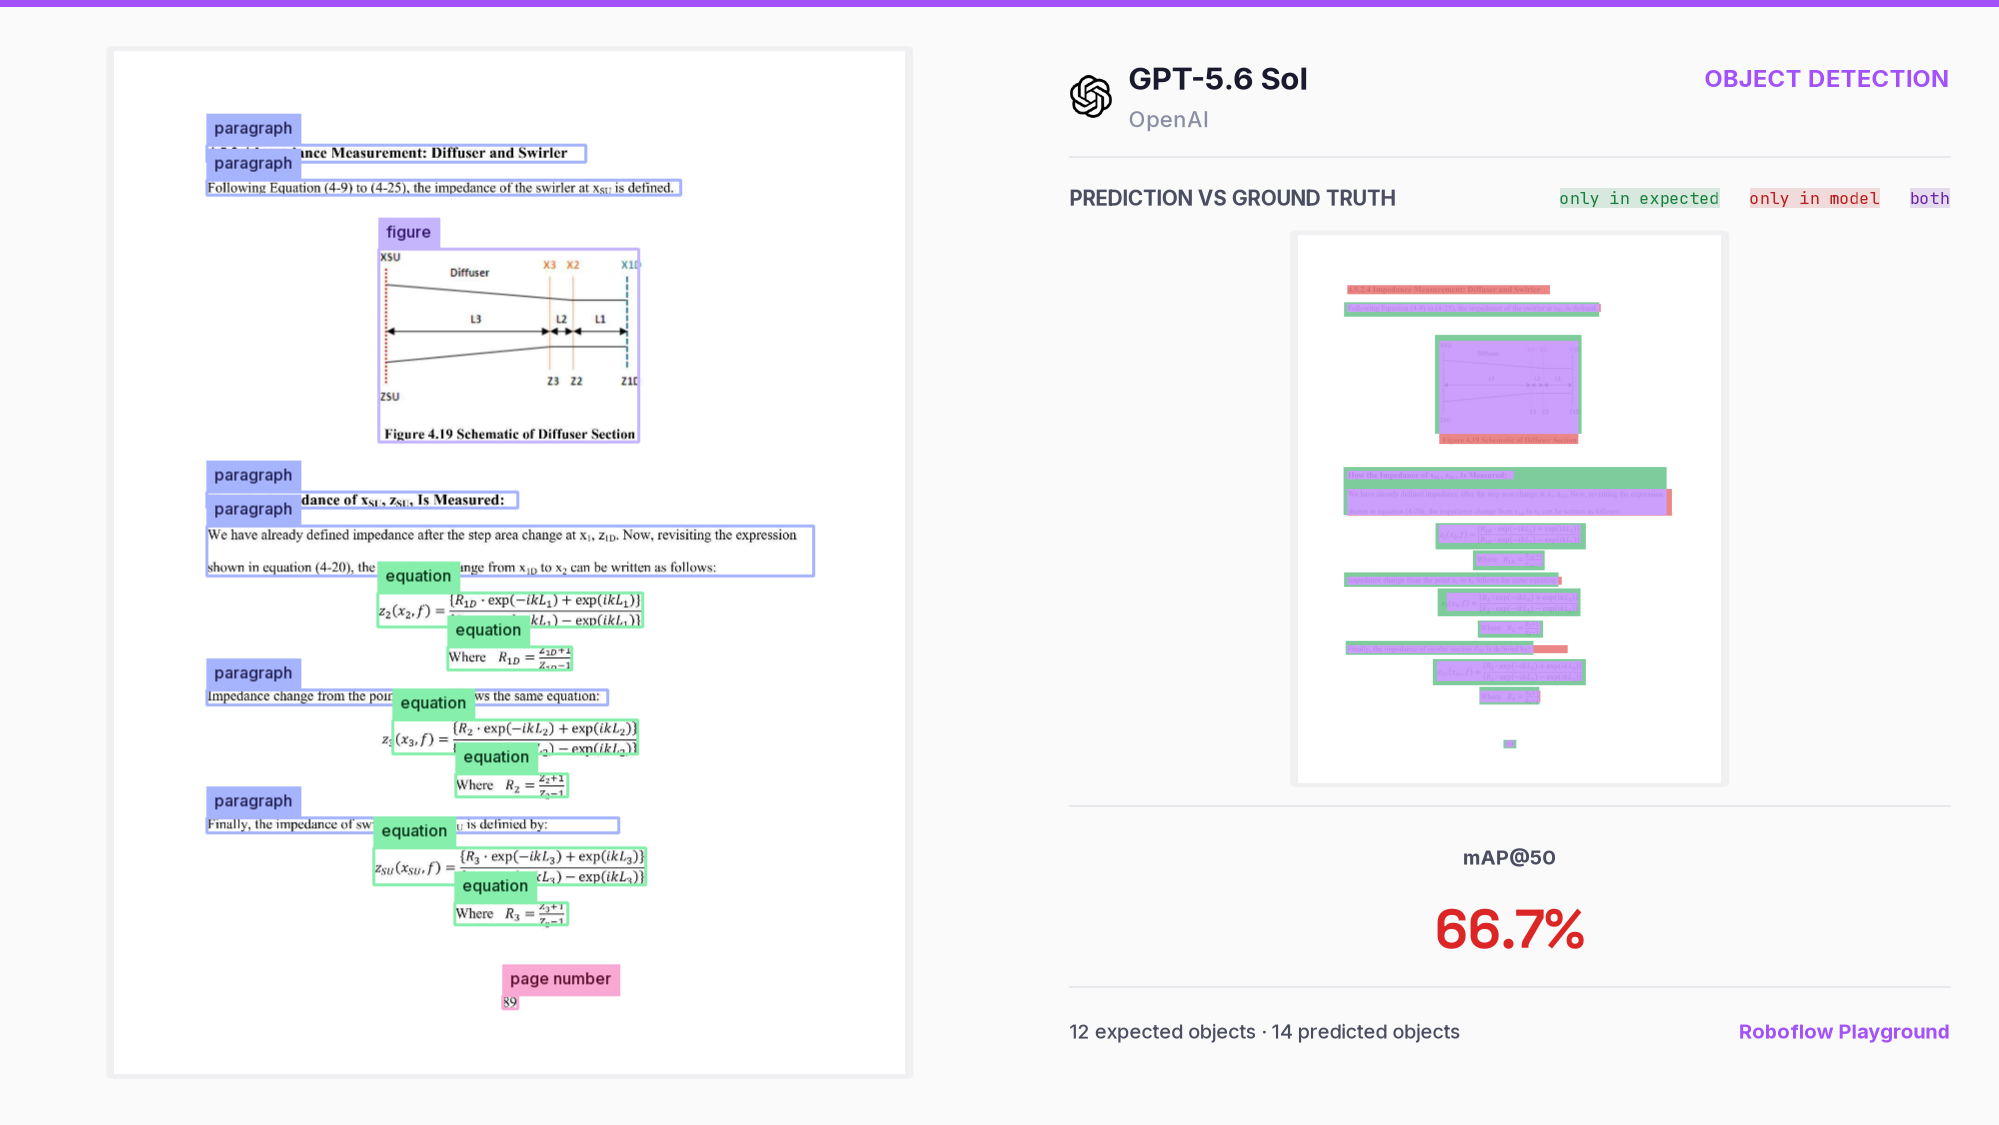
文档布局检测是 GPT-5.6 最明显的优势之一。Sol 能很好地处理标题、段落、表格、图片和签名。许多文档工作流从定位页面相关部分开始,然后进行 OCR 或数据提取。
GPT-5.6 在密集场景中也表现良好。药丸和鸡蛋示例包含许多相似物体紧密排列,这是 VLM 检测常见的弱点。与传统检测器不同,VLM 将每个类别标签和坐标集生成为文本。随着物体数量增加,响应变长,遗漏、重复或坐标错误的风险增加。尽管如此,Sol 在两个场景中检测到了大多数物体。
为了获得最佳检测结果,请提示 GPT-5.6 模型返回图像像素中的绝对 XYXY 坐标。这与 Gemini 3.5 Flash 不同,后者使用归一化到 0–1000 范围的 YXYX 坐标时表现最佳。在我们的基准测试中,使用错误的坐标格式使 GPT-5.6 的检测性能下降了约 15 个 mAP 点。
在少数情况下,GPT-5.6 Sol 返回的边界框出现在图像中看似随机的位置。许多与真实标注没有重叠或几乎没有重叠。这些框往往没有匹配可见物体,而是形成不自然的布局,例如直线排列或均匀间隔的组。
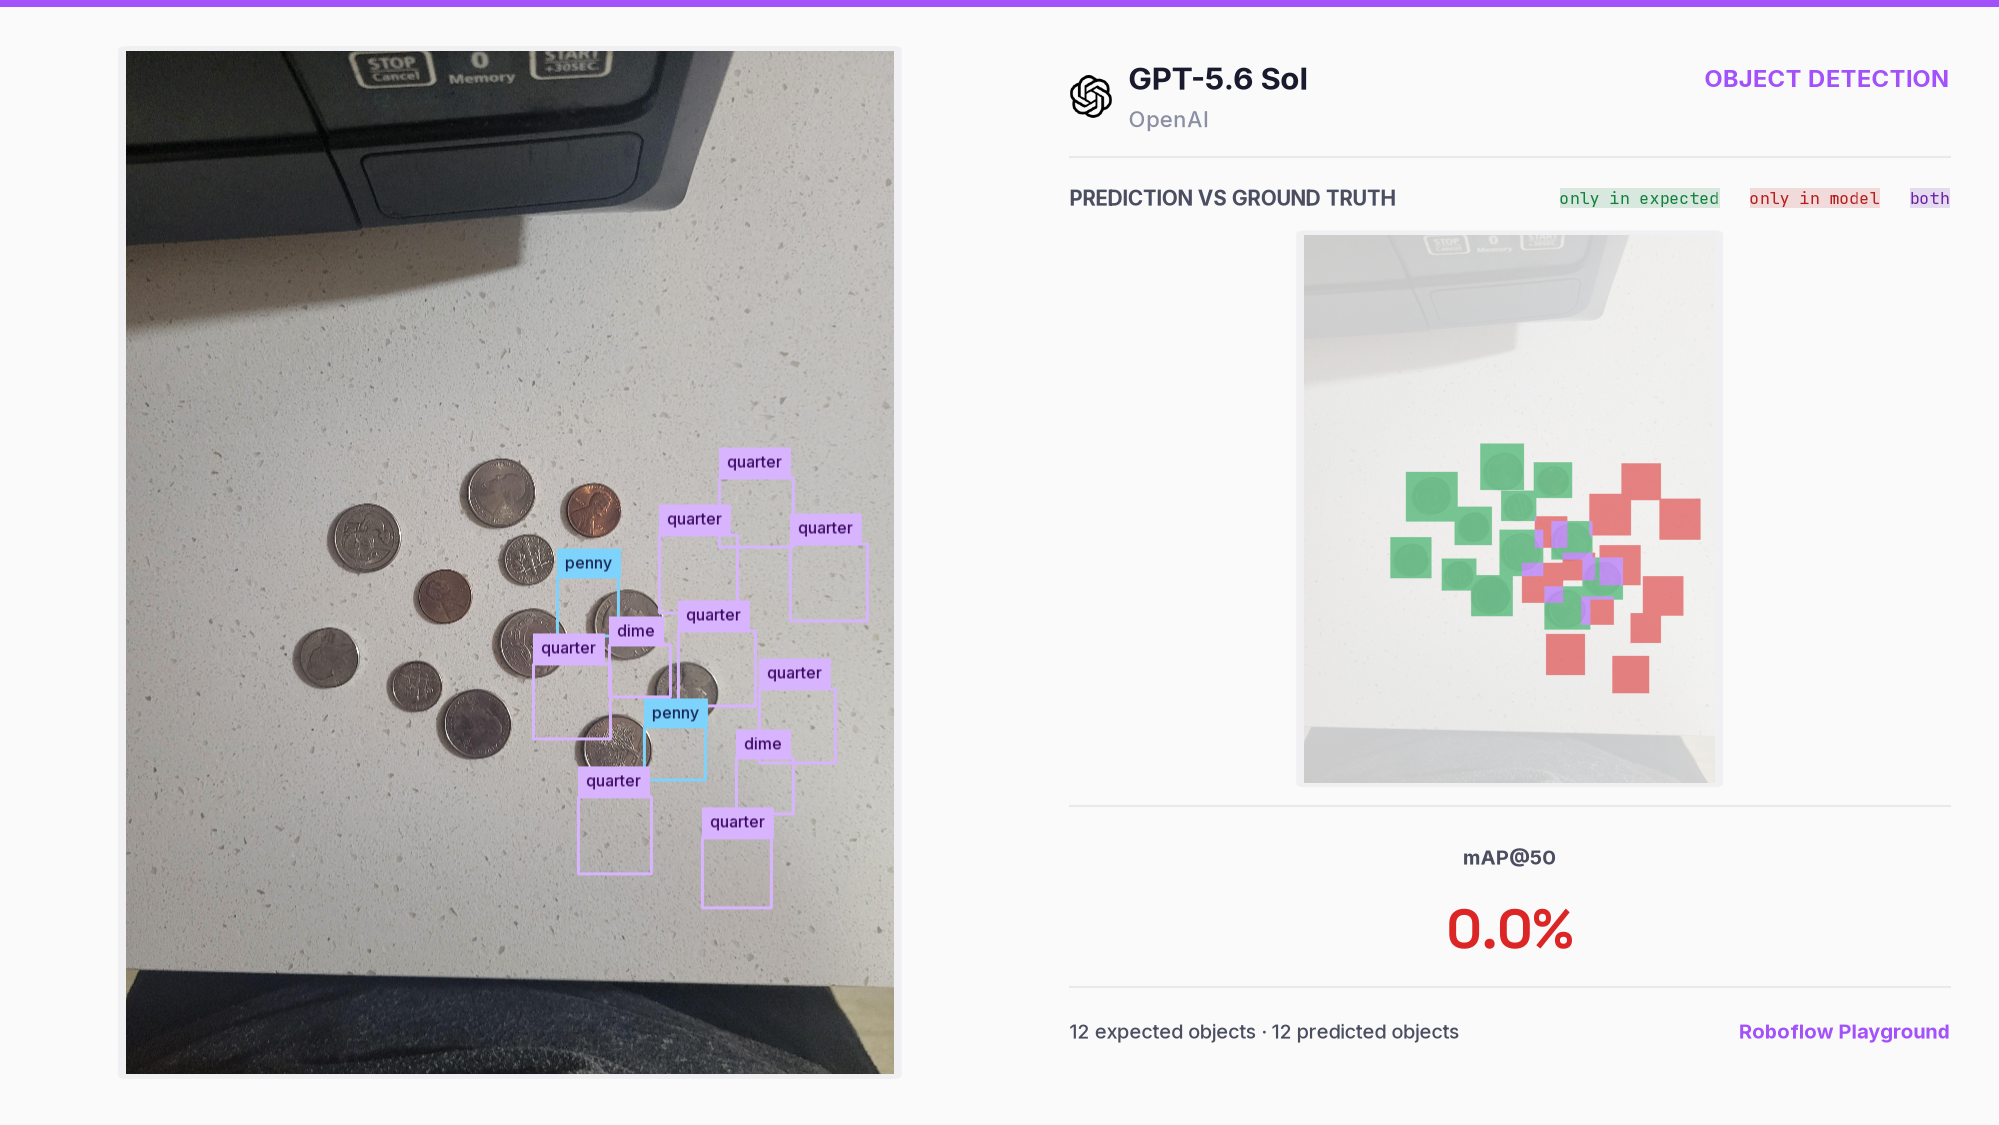
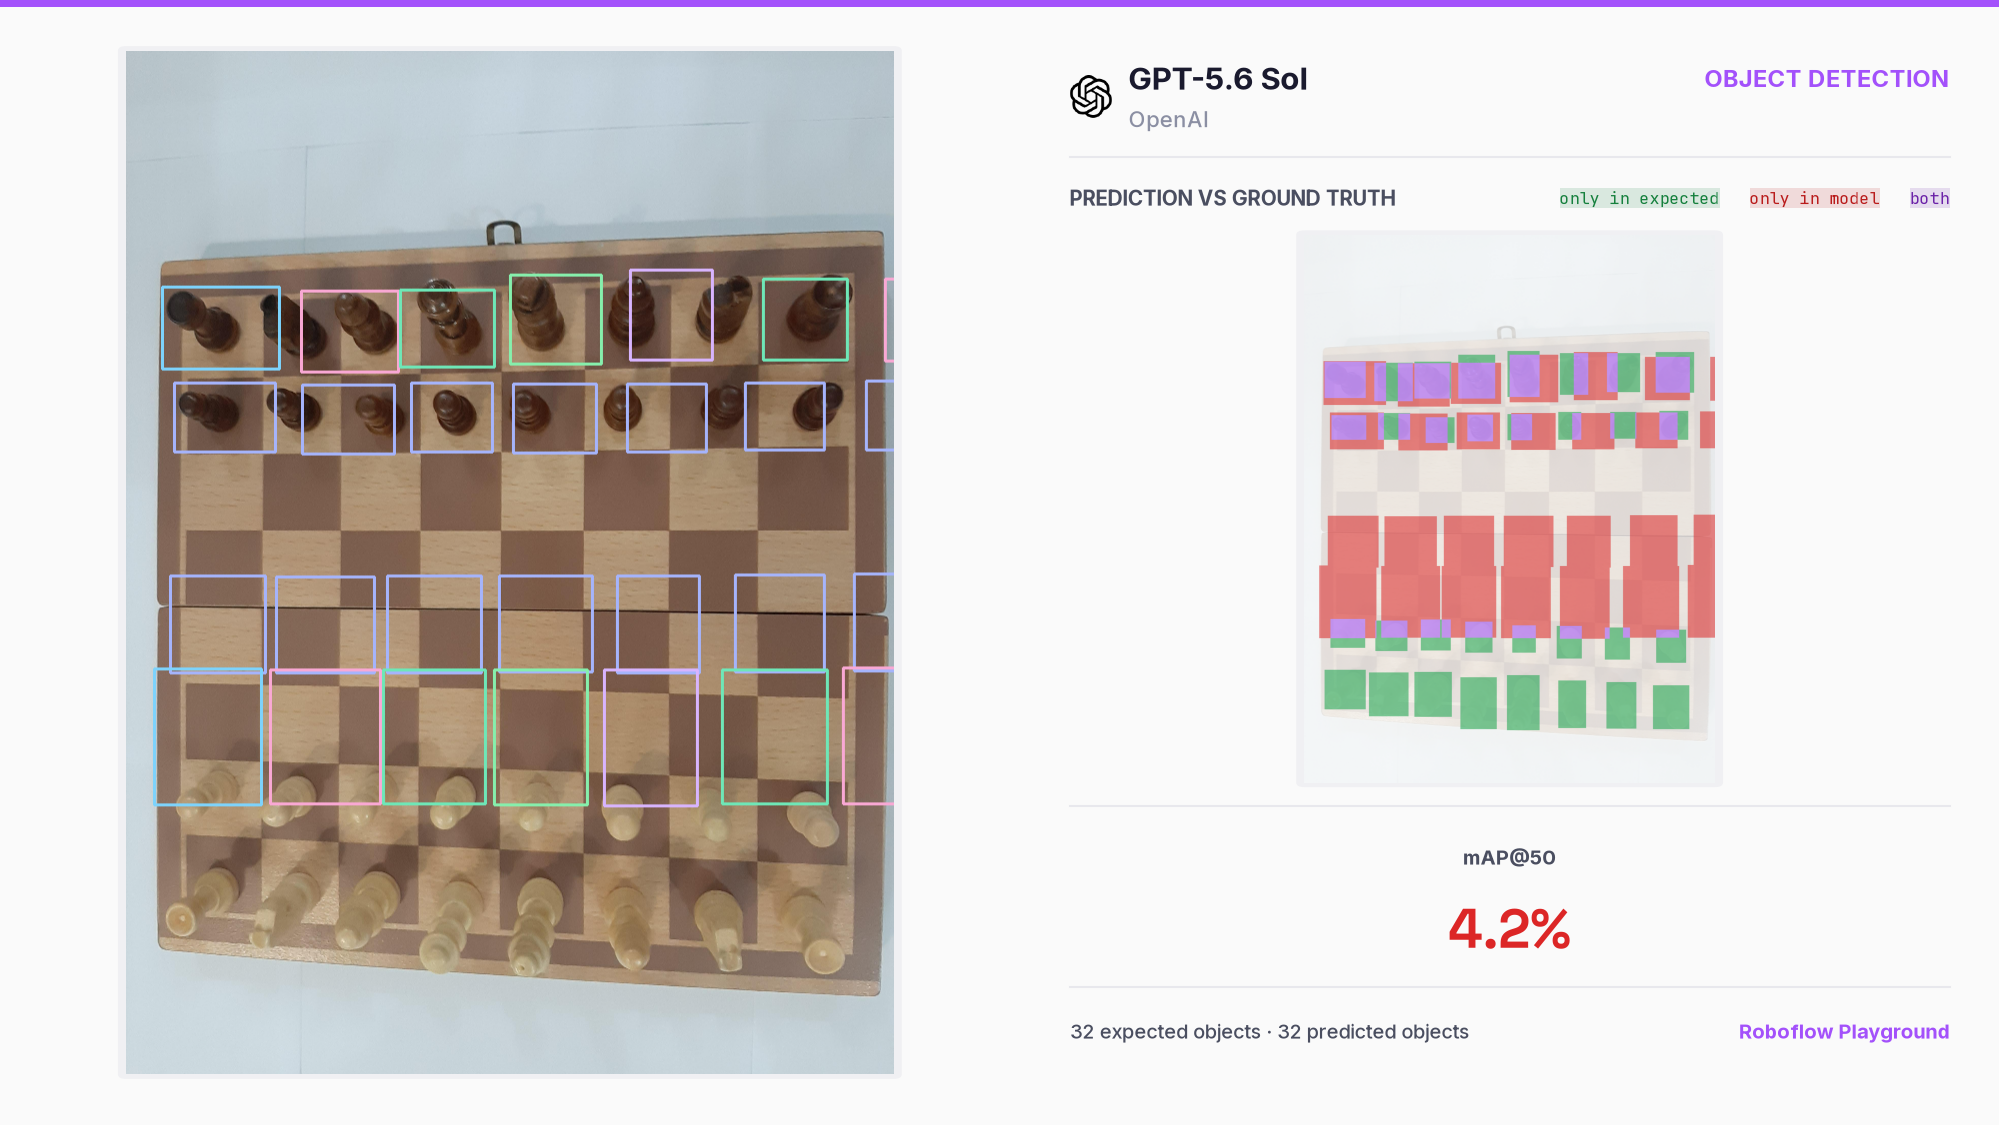
我们将这些示例分享给了 OpenAI。他们的团队确认,Sol 在约 2000×2000 像素或更大的图像上会变得不太稳定,尤其是在较低推理努力下。更高的推理努力会提高稳定性,但也会增加 token 使用量、延迟和成本。在将大图像发送到 OpenAI API 之前调整大小或裁剪是最实用的解决方法。
对象计数
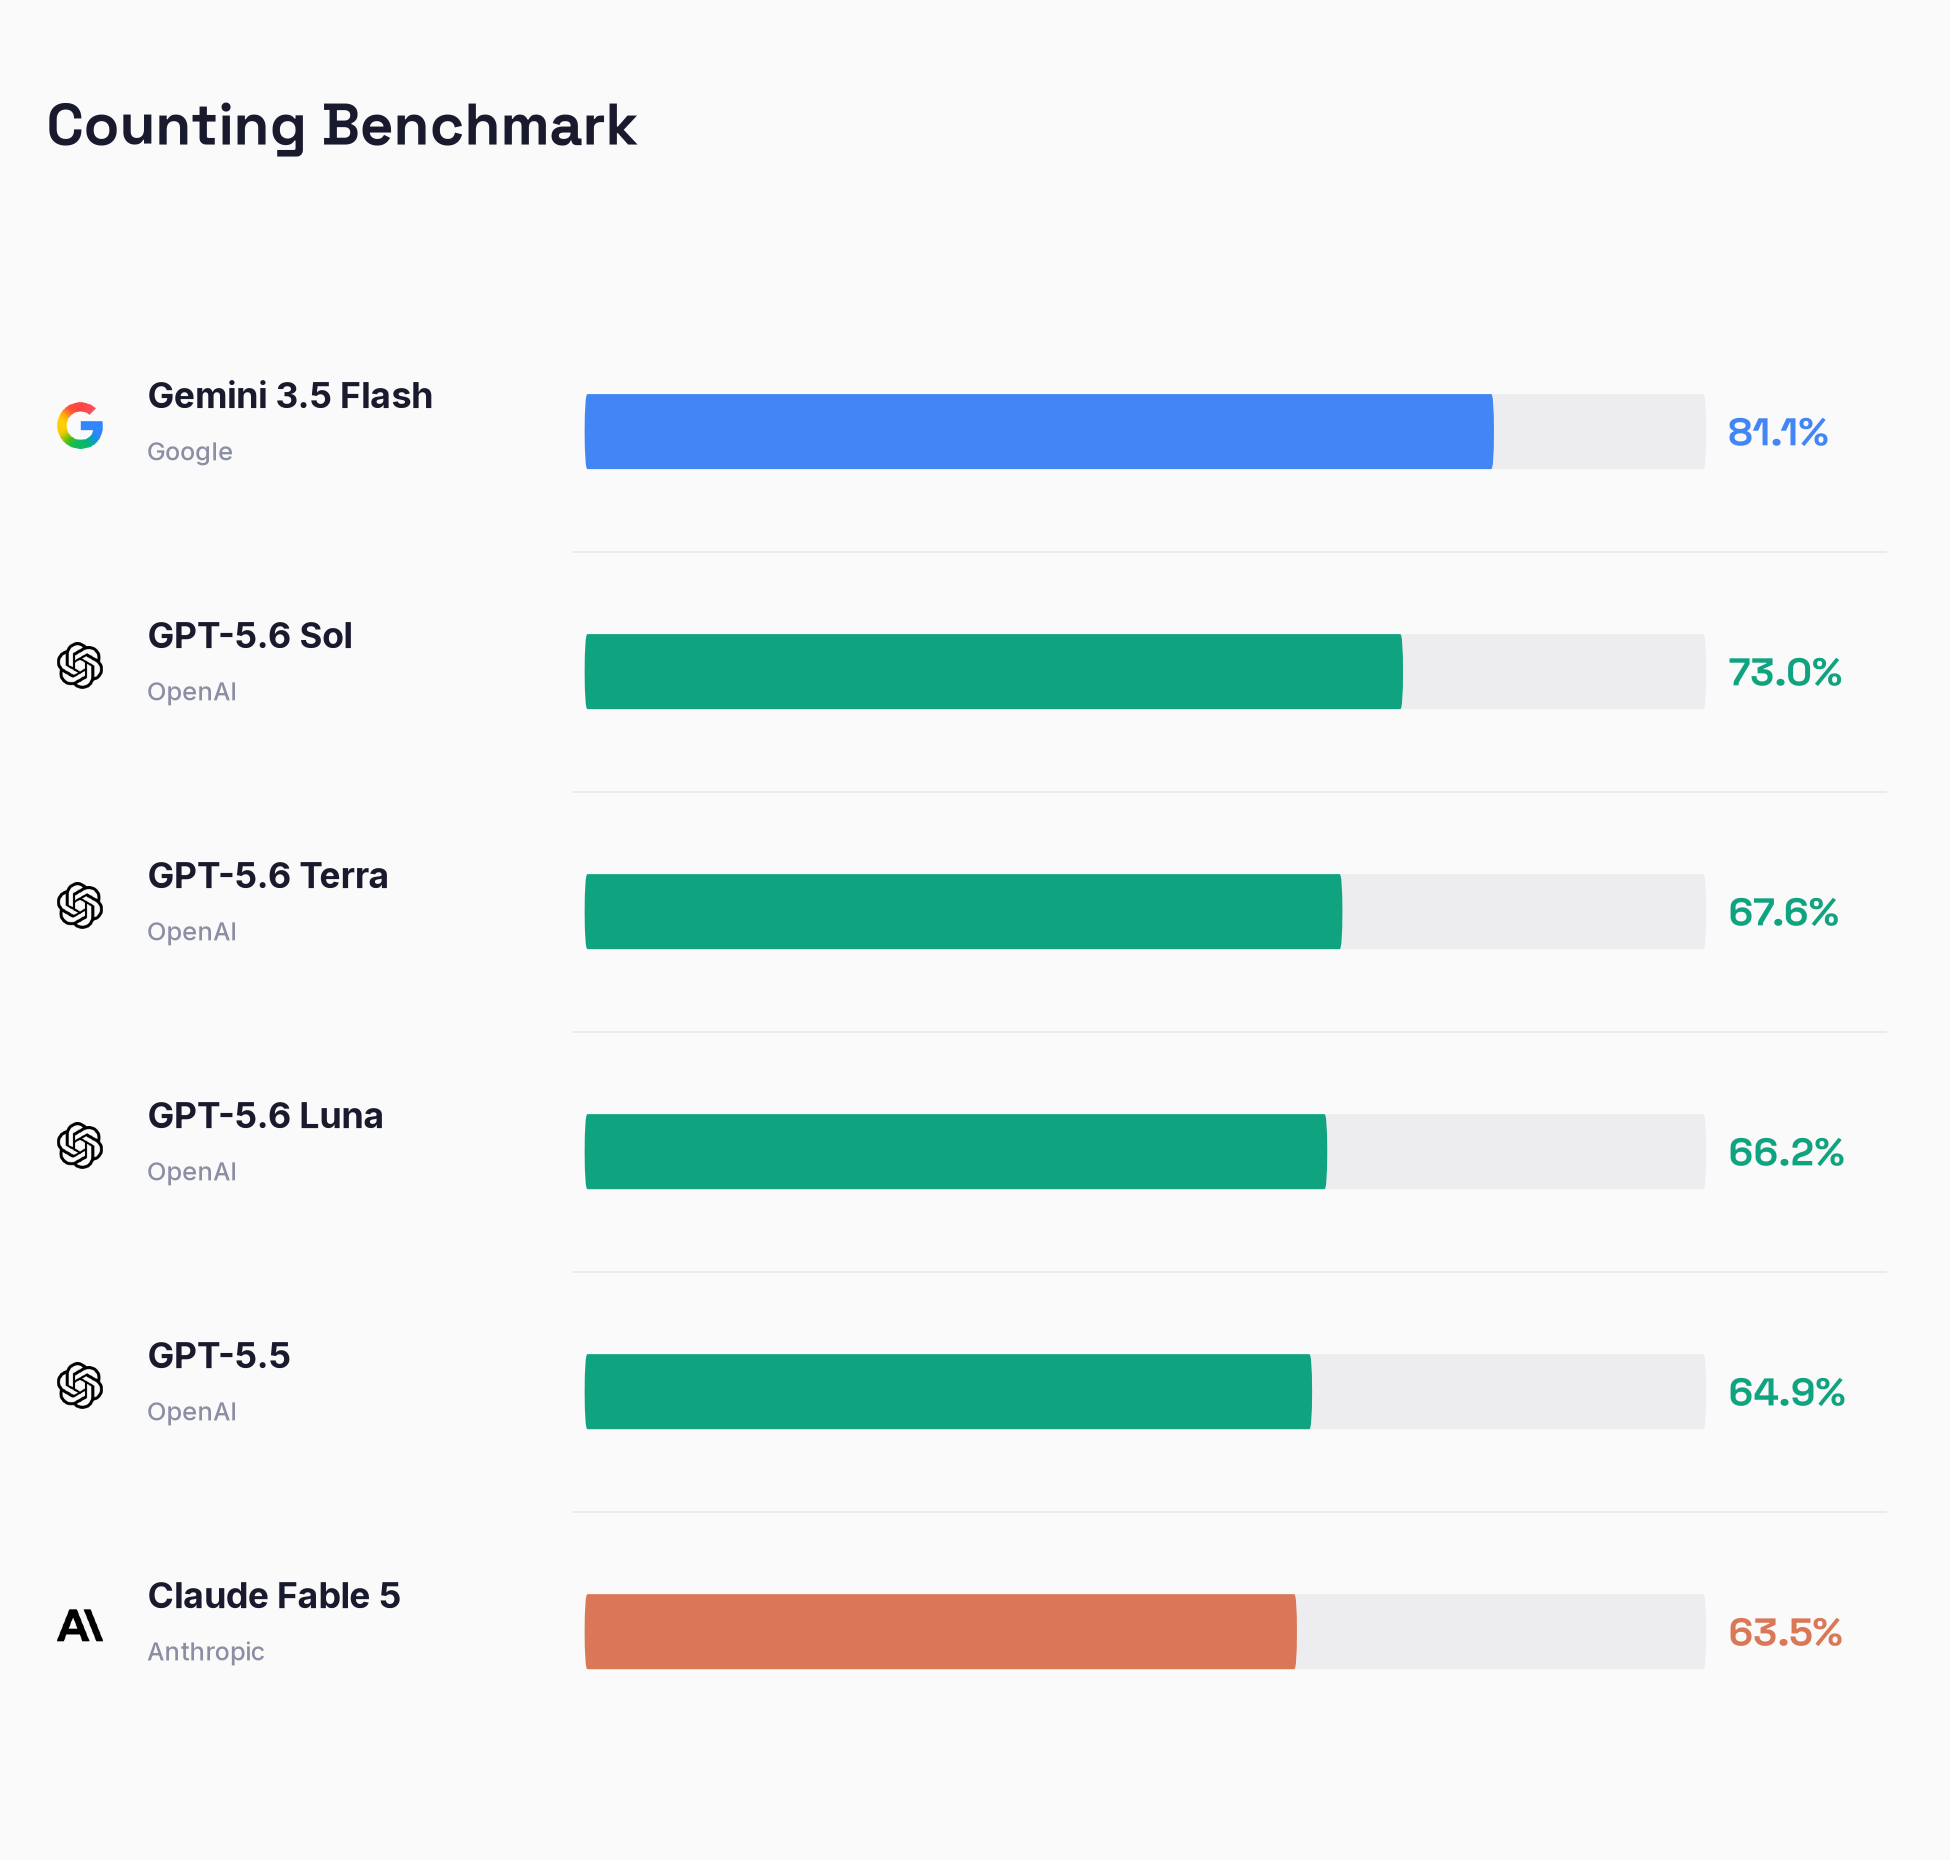
整个 GPT-5.6 系列的计数能力都有所提升。Sol 在我们的基准测试中得分为 73.0%,高于 GPT-5.5 的 64.9%,而 Terra 和 Luna 分别达到 67.6% 和 66.2%。Luna 是系列中最便宜的模型,仍然超过了 OpenAI 之前的基线。
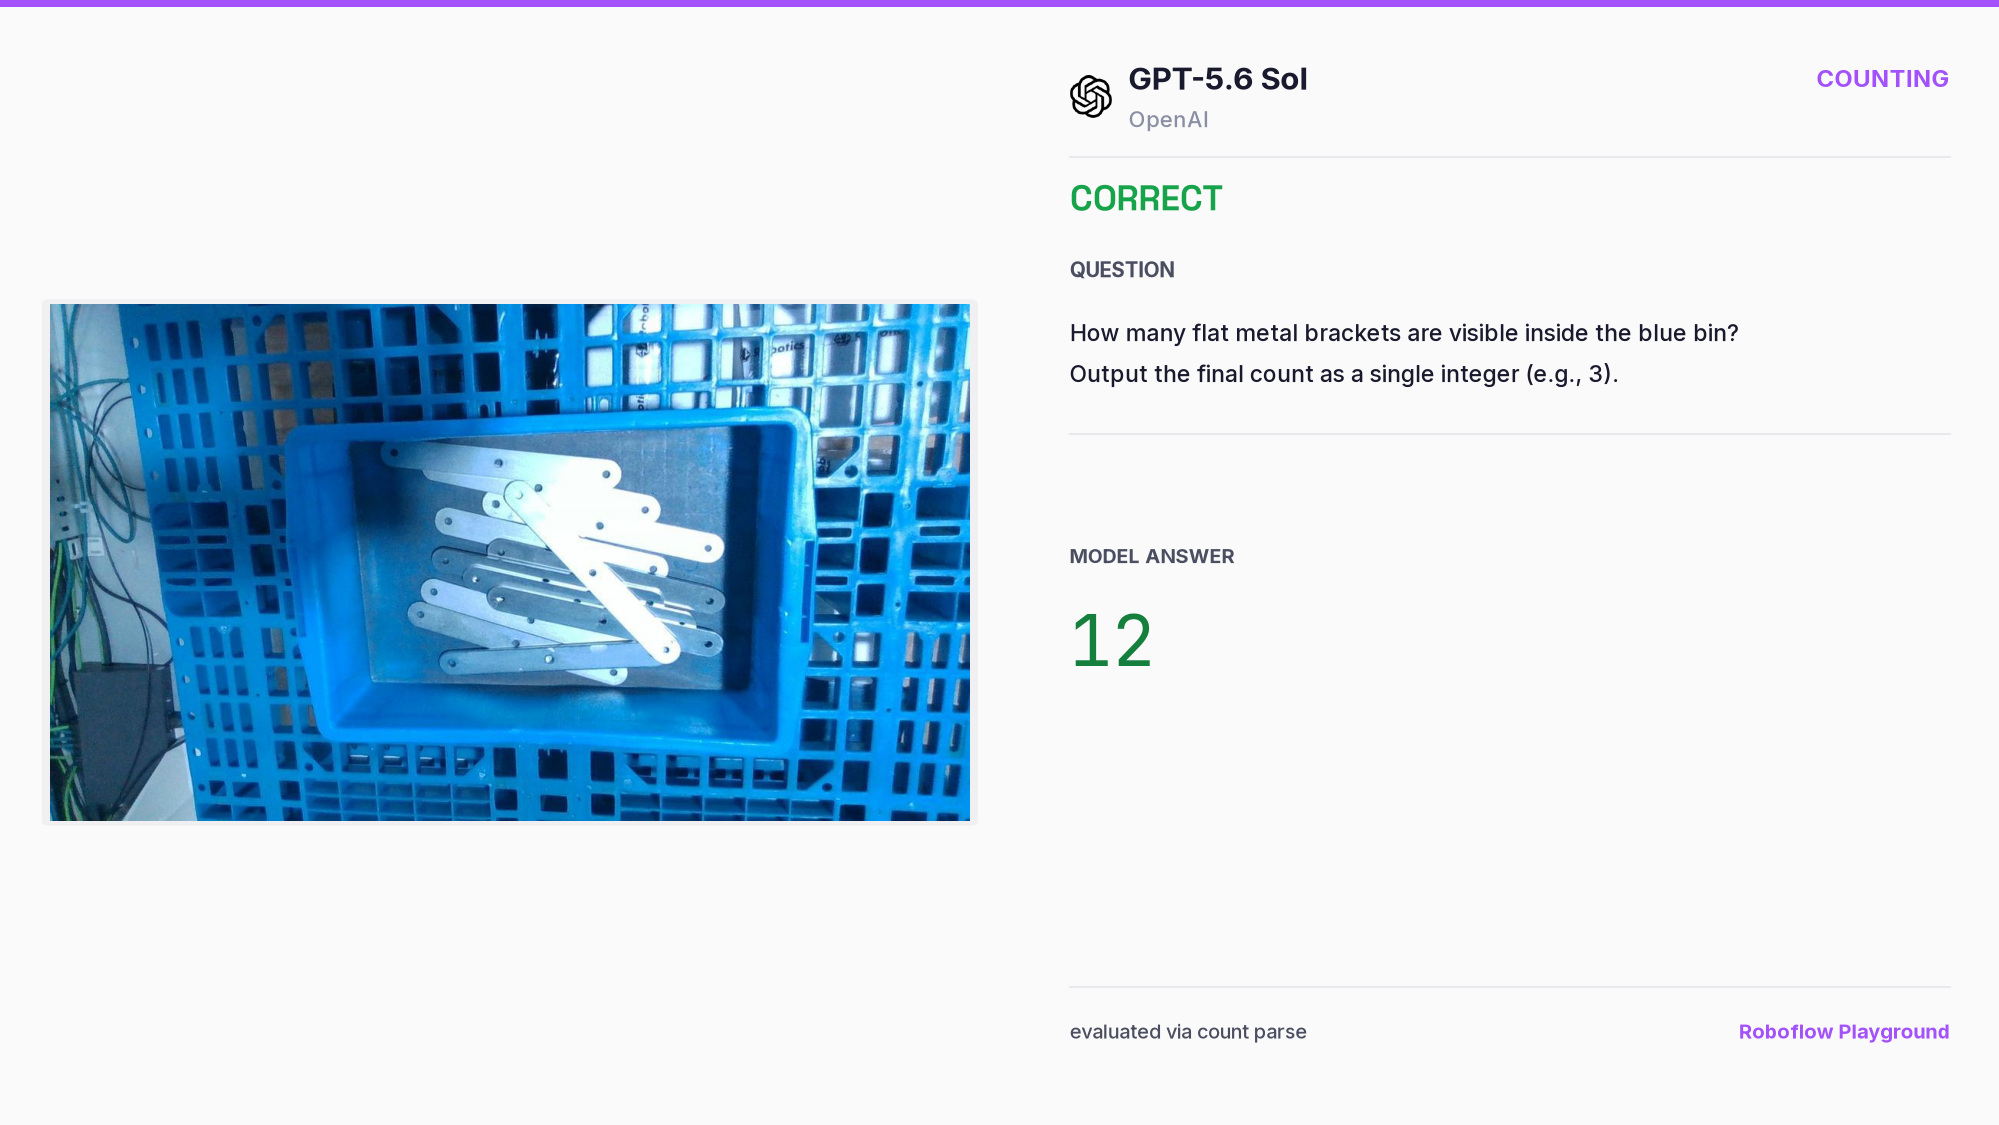
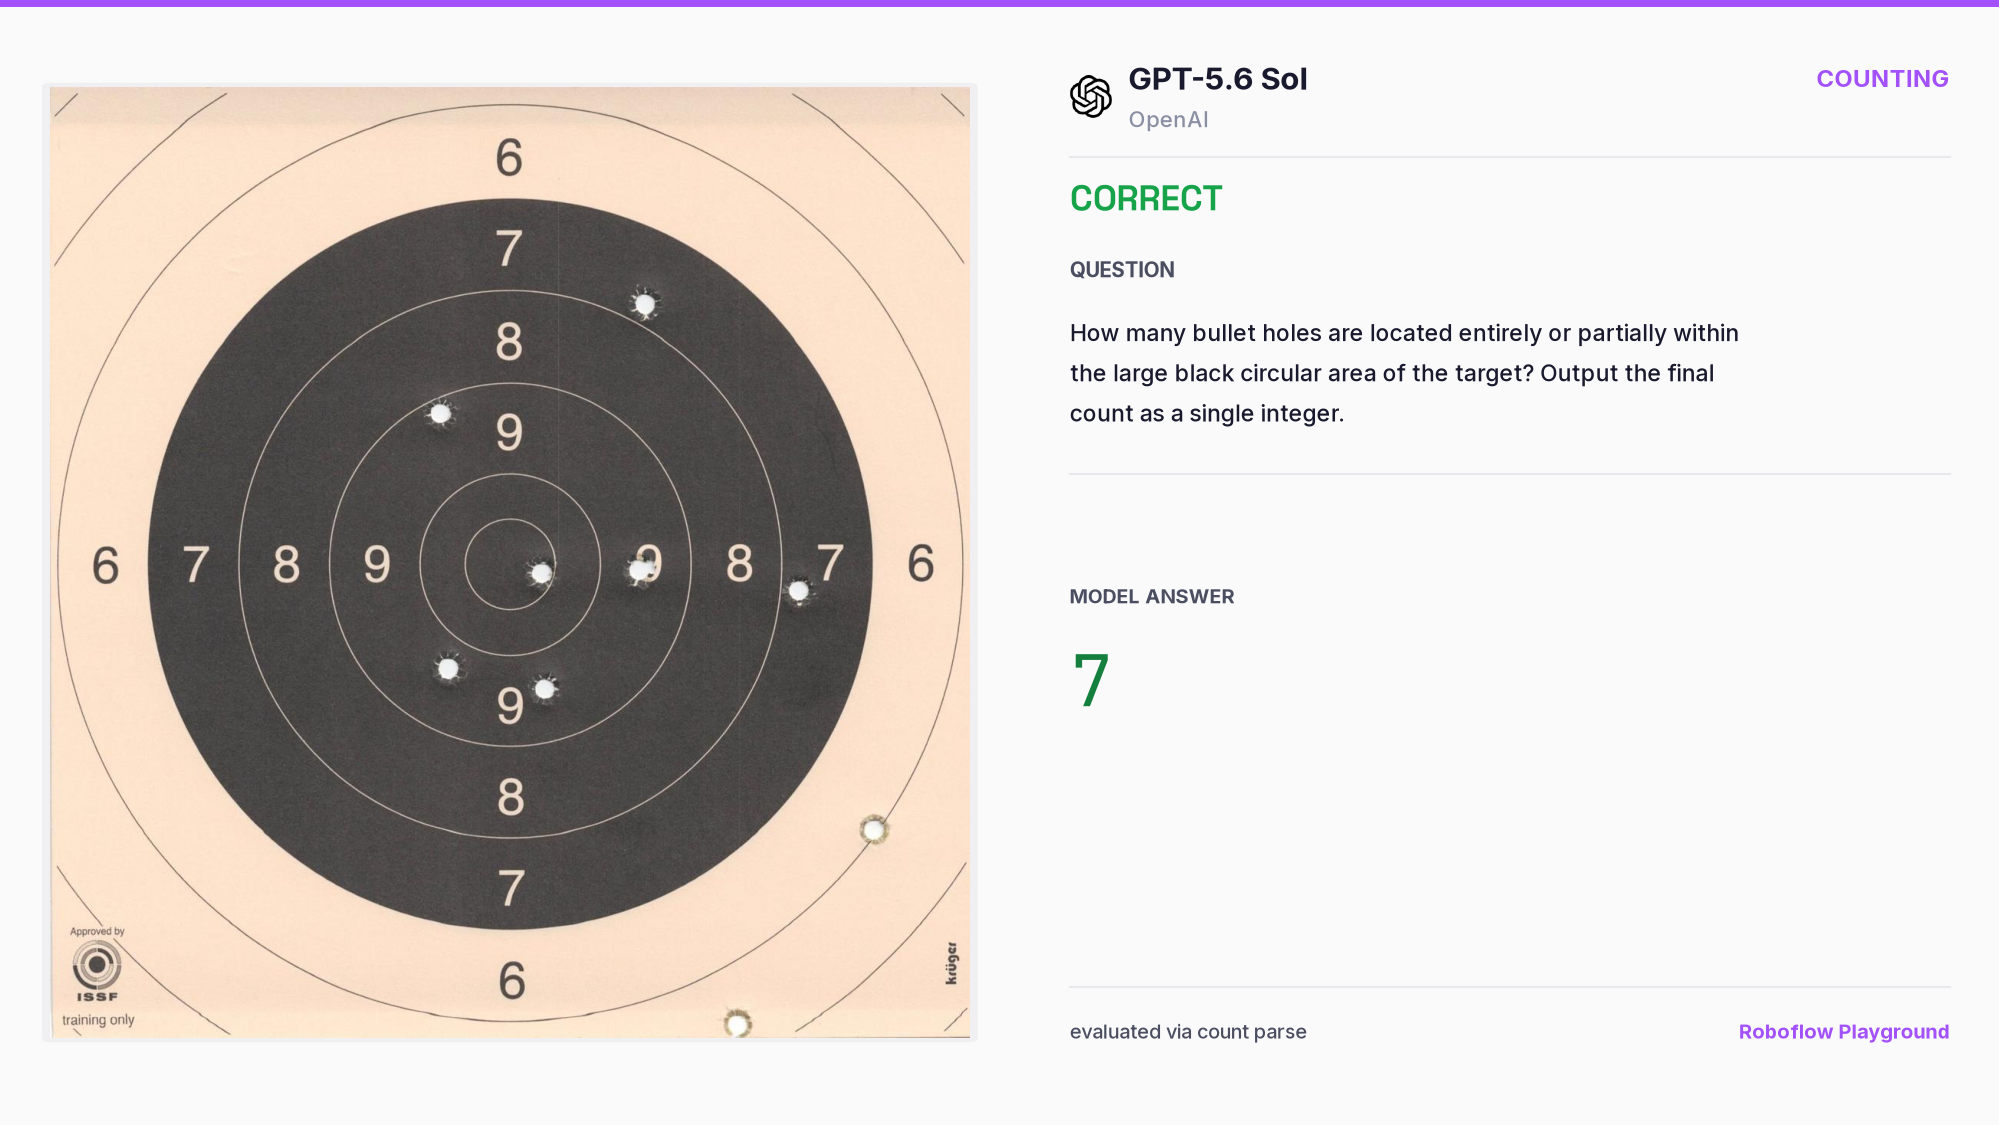
作为基准测试的一部分,我们测试了不仅需要识别物体并返回总数的情况。Sol 成功计算了高度重叠的金属支架,这对传统目标检测器和 VLM 来说都是困难的情况。Sol 还只统计了选定得分区域内的弹孔,显示它既理解要计数哪些物体,也理解规则适用的位置。
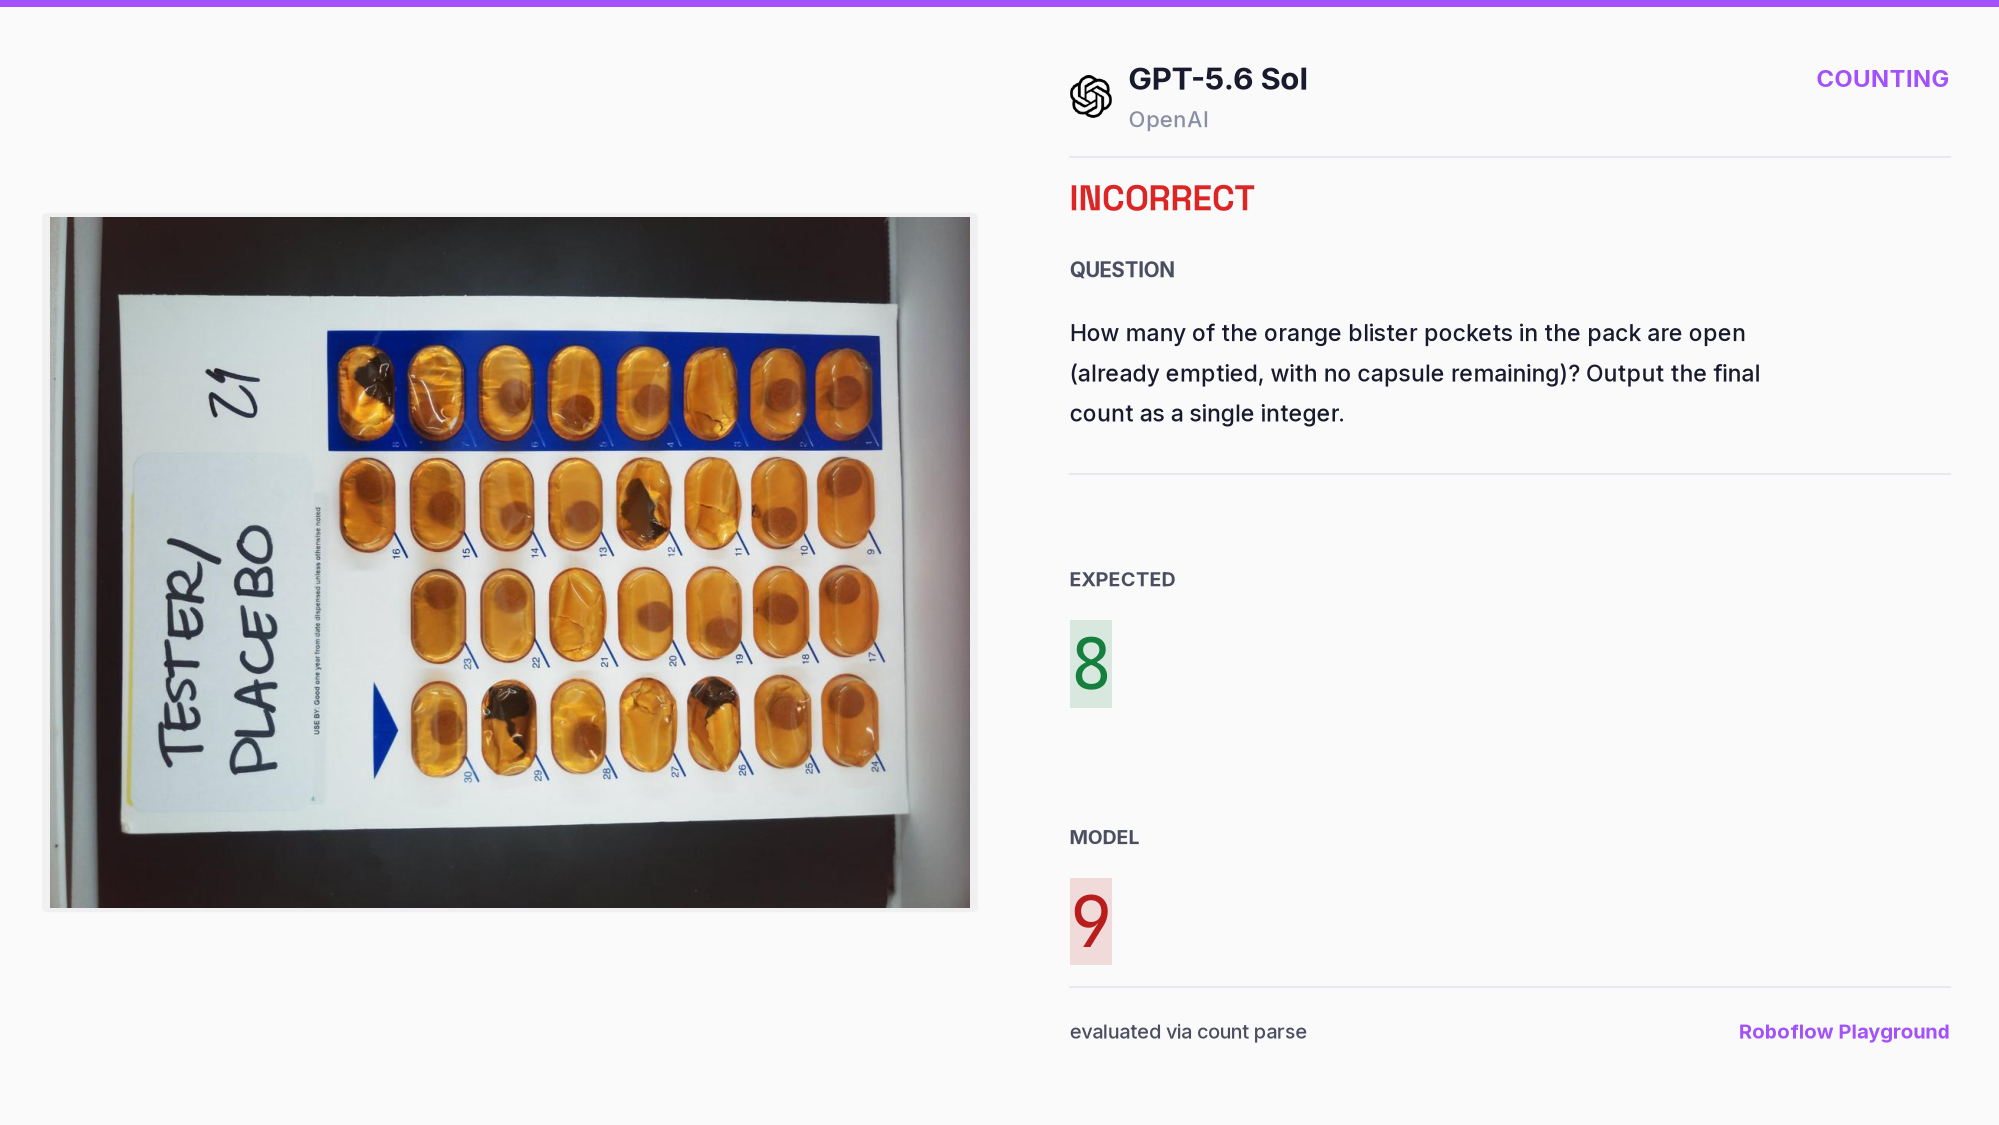
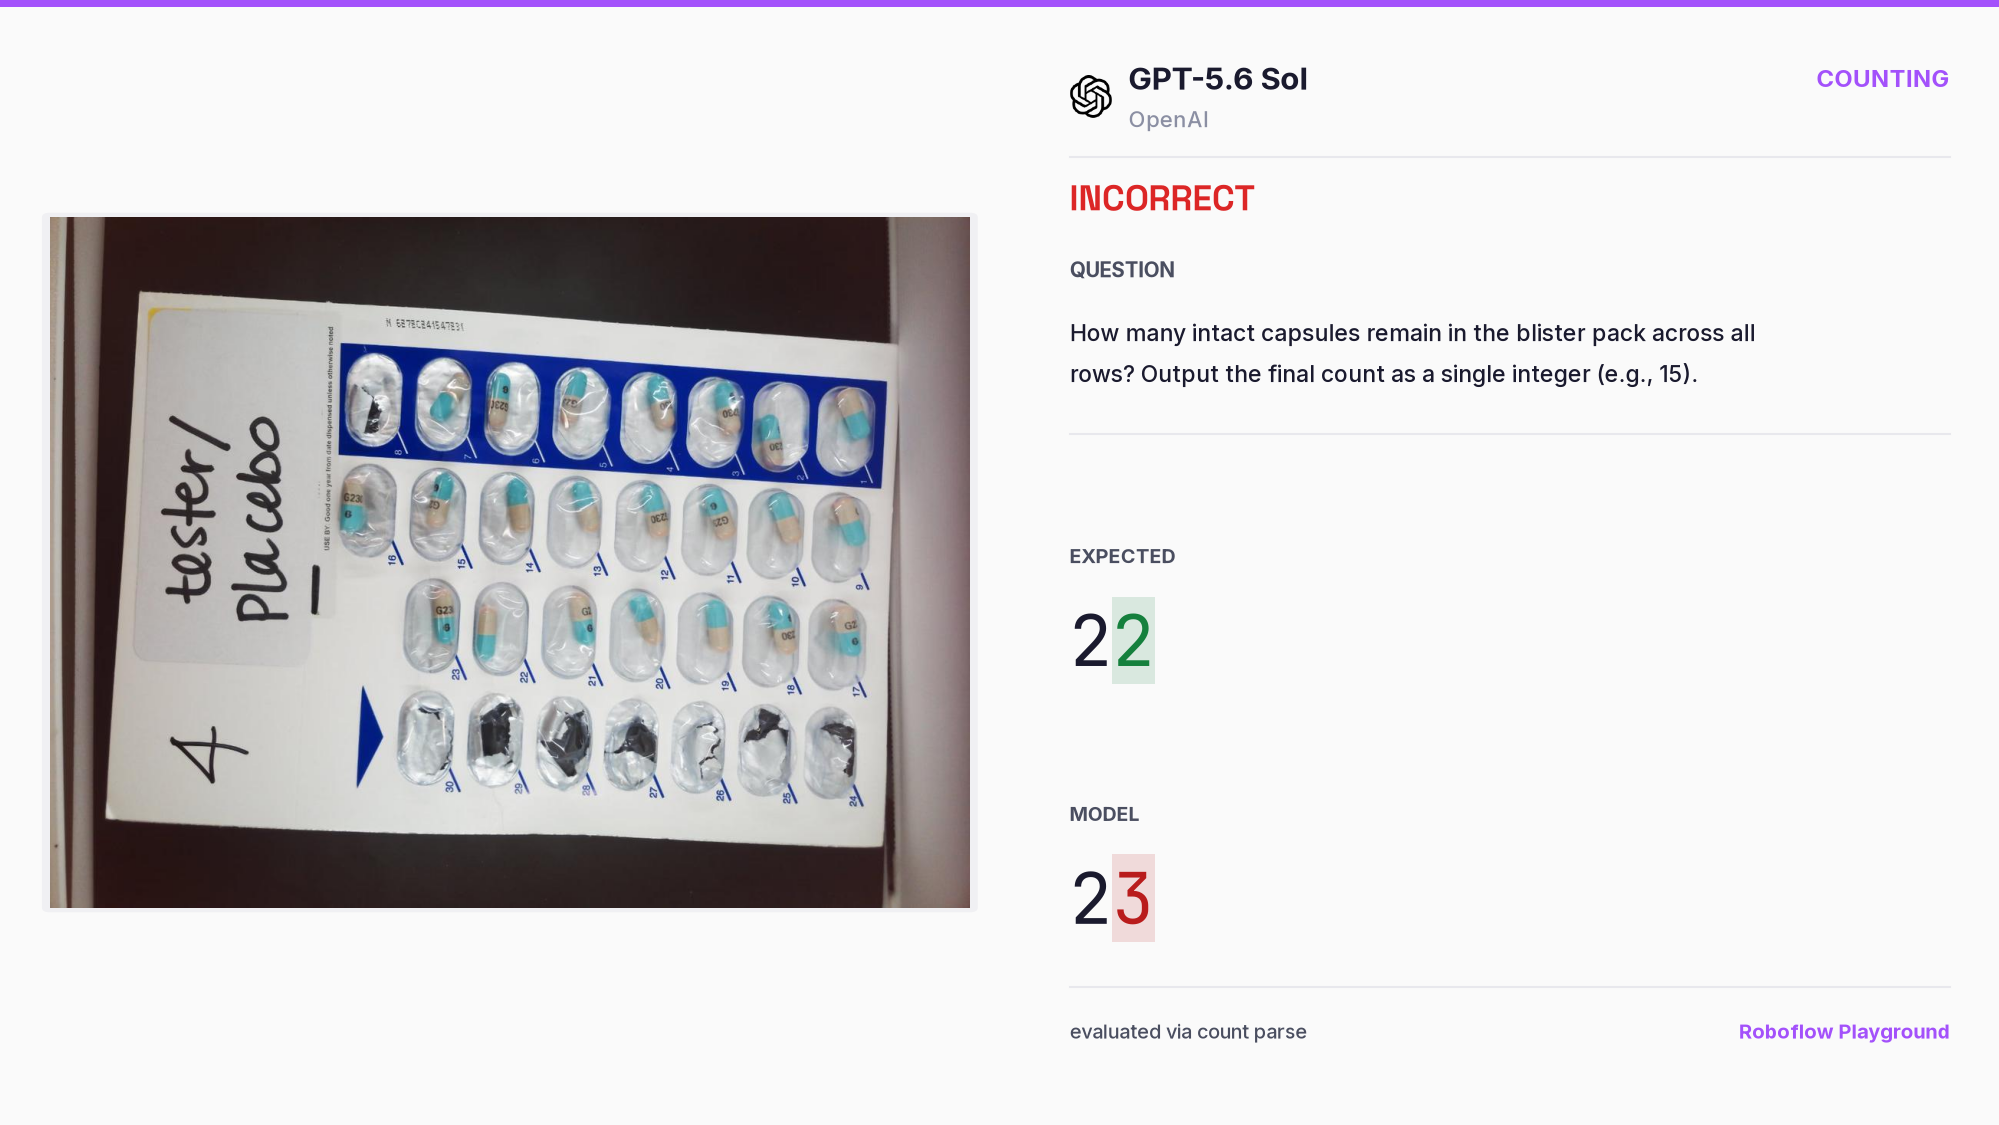
泡罩包装则困难得多。在单独的提示中,我们要求 Sol 计算空槽位和仍密封在包装内的药丸。重复的布局、反光以及满槽和空槽之间的微小视觉差异使这两项任务都很困难。
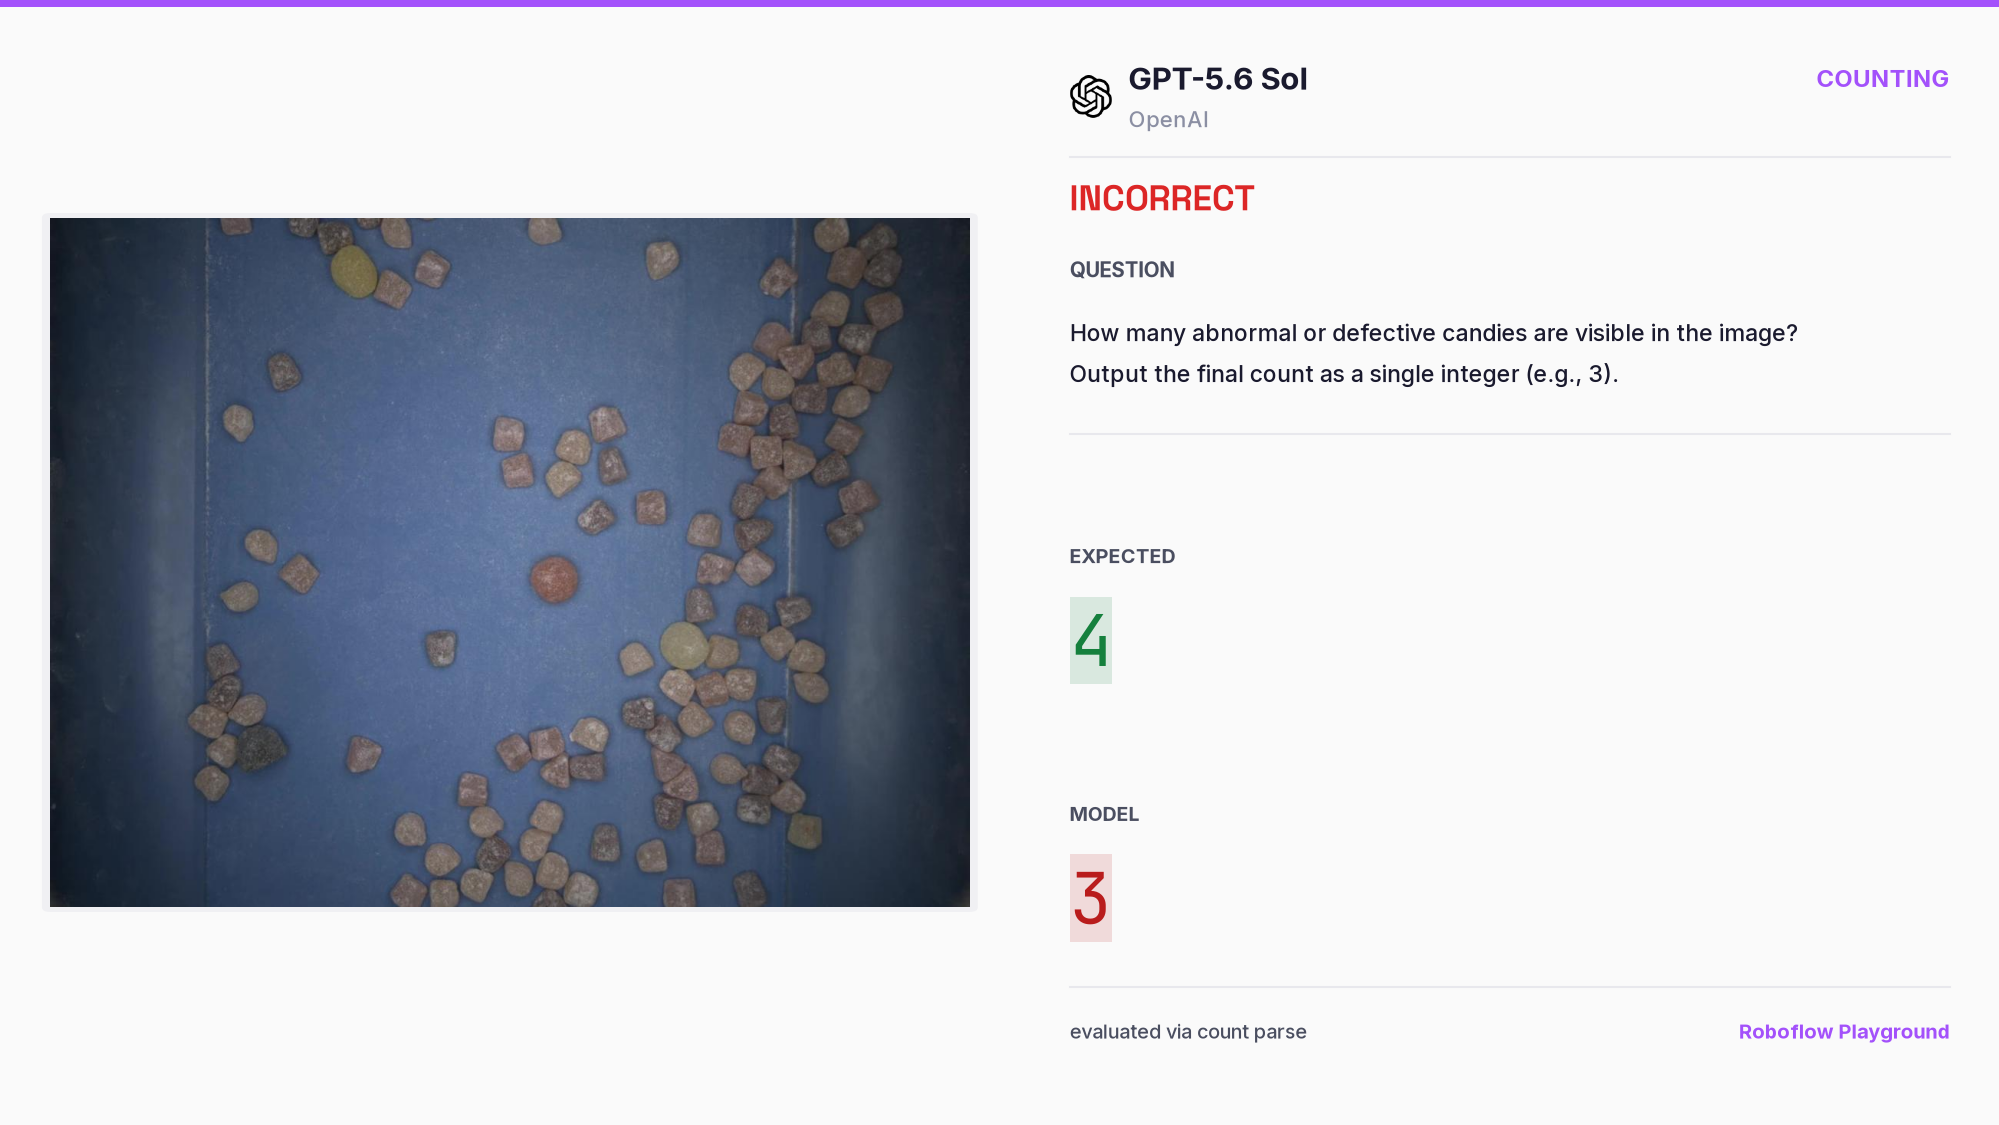
异常糖果示例暴露了另一种失败类型。Sol 给出了错误的计数,但不清楚模型是数错了糖果还是误解了目标类别。
OCR 与数据提取
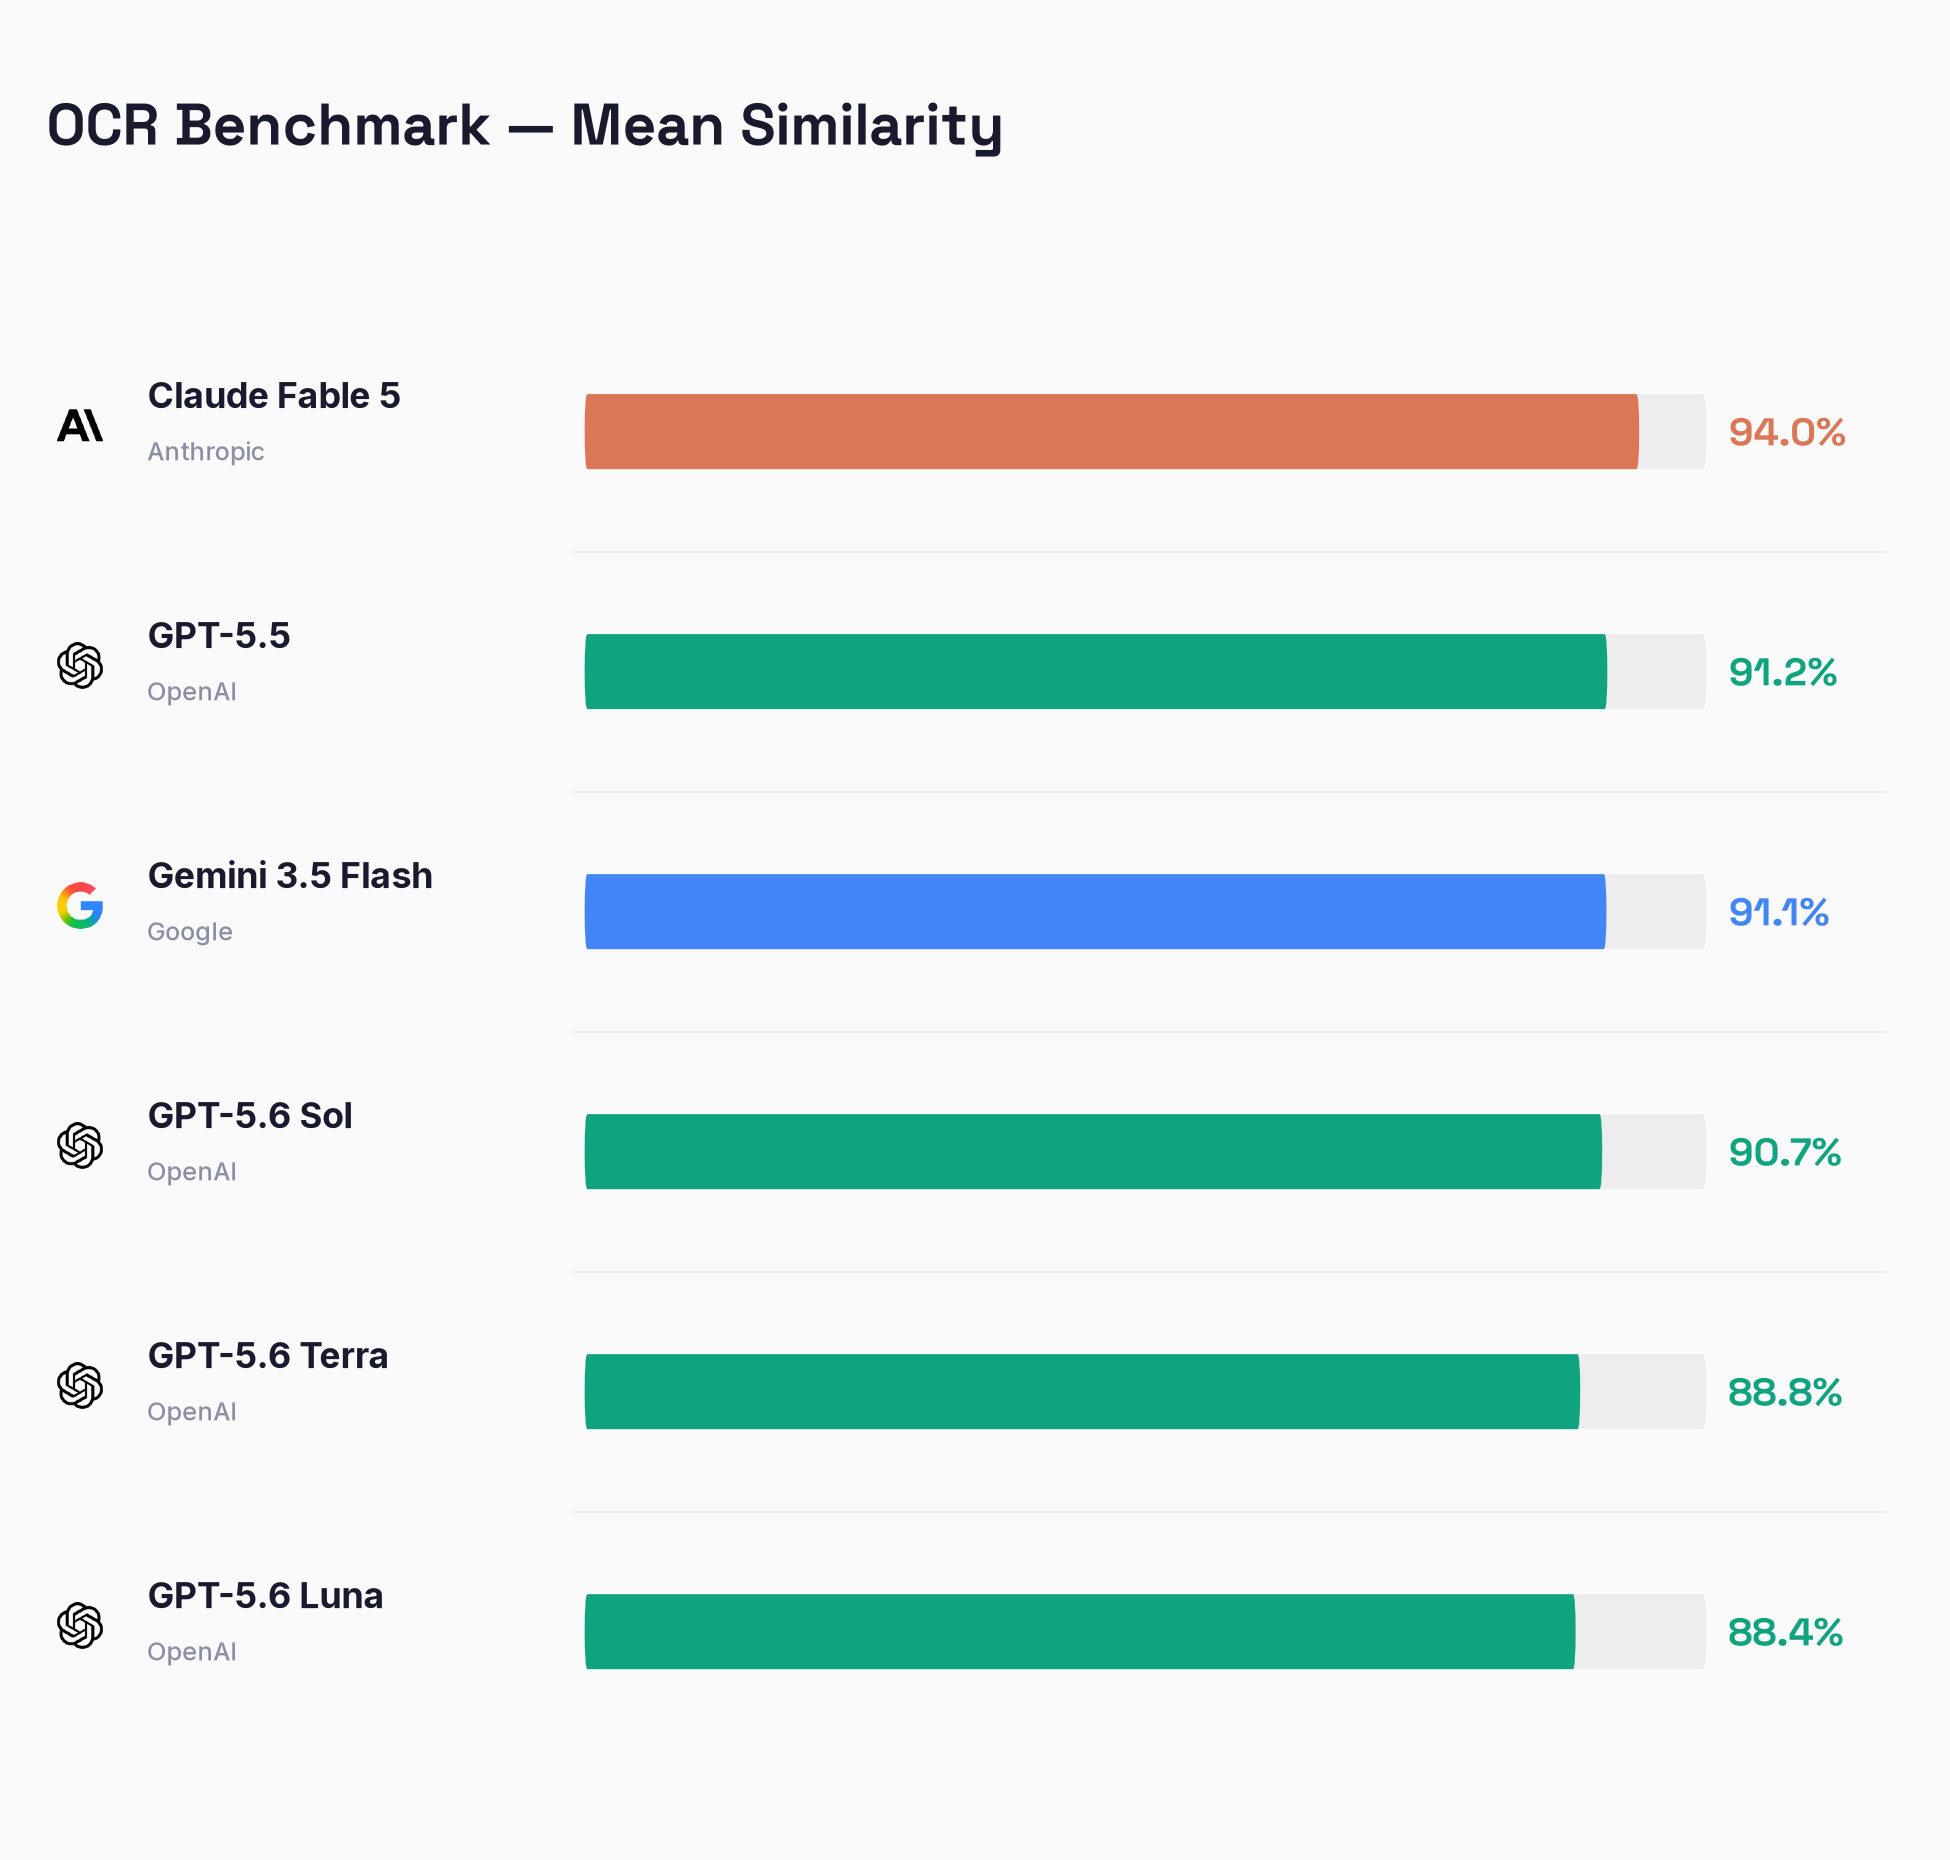
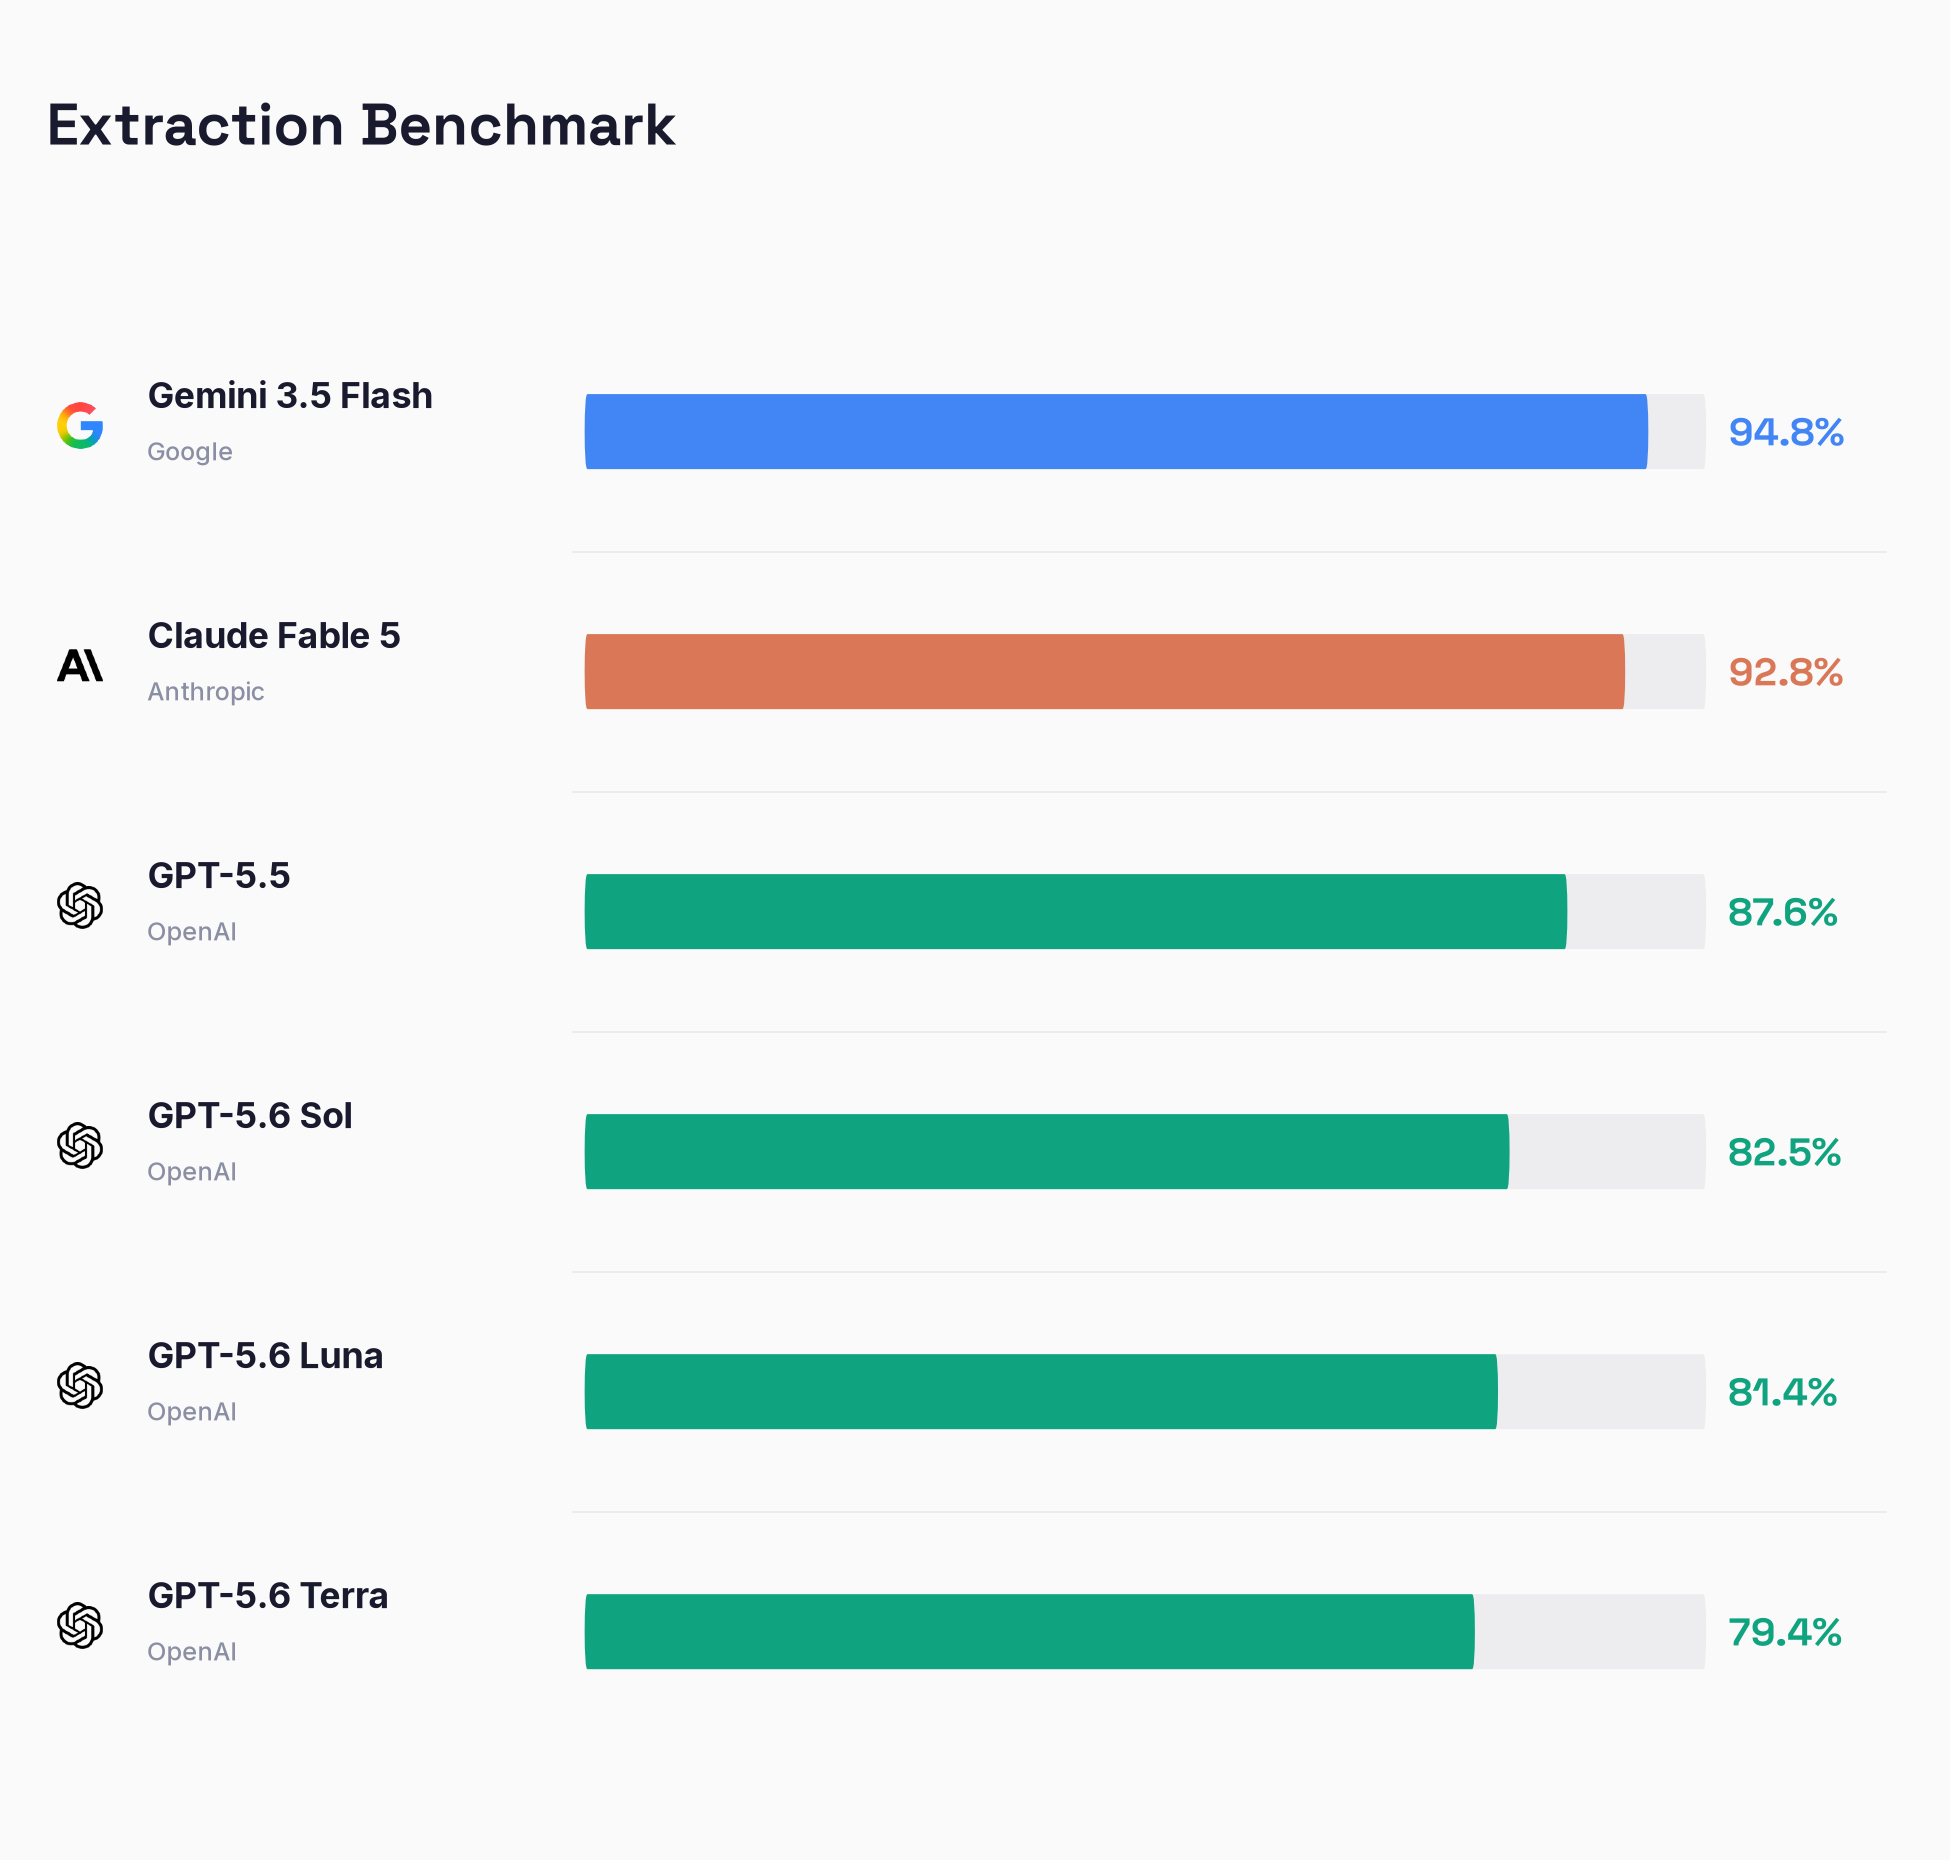
OCR 性能与 GPT-5.5 接近。Sol 的平均相似度得分为 90.7%,仅比 GPT-5.5 的 91.2% 低 0.5 个百分点,而 Terra 和 Luna 分别达到 88.8% 和 88.4%。文本提取的差距更大,Sol 得分为 82.5%,而 GPT-5.5 为 87.6%。Luna 和 Terra 分别为 81.4% 和 79.4%。
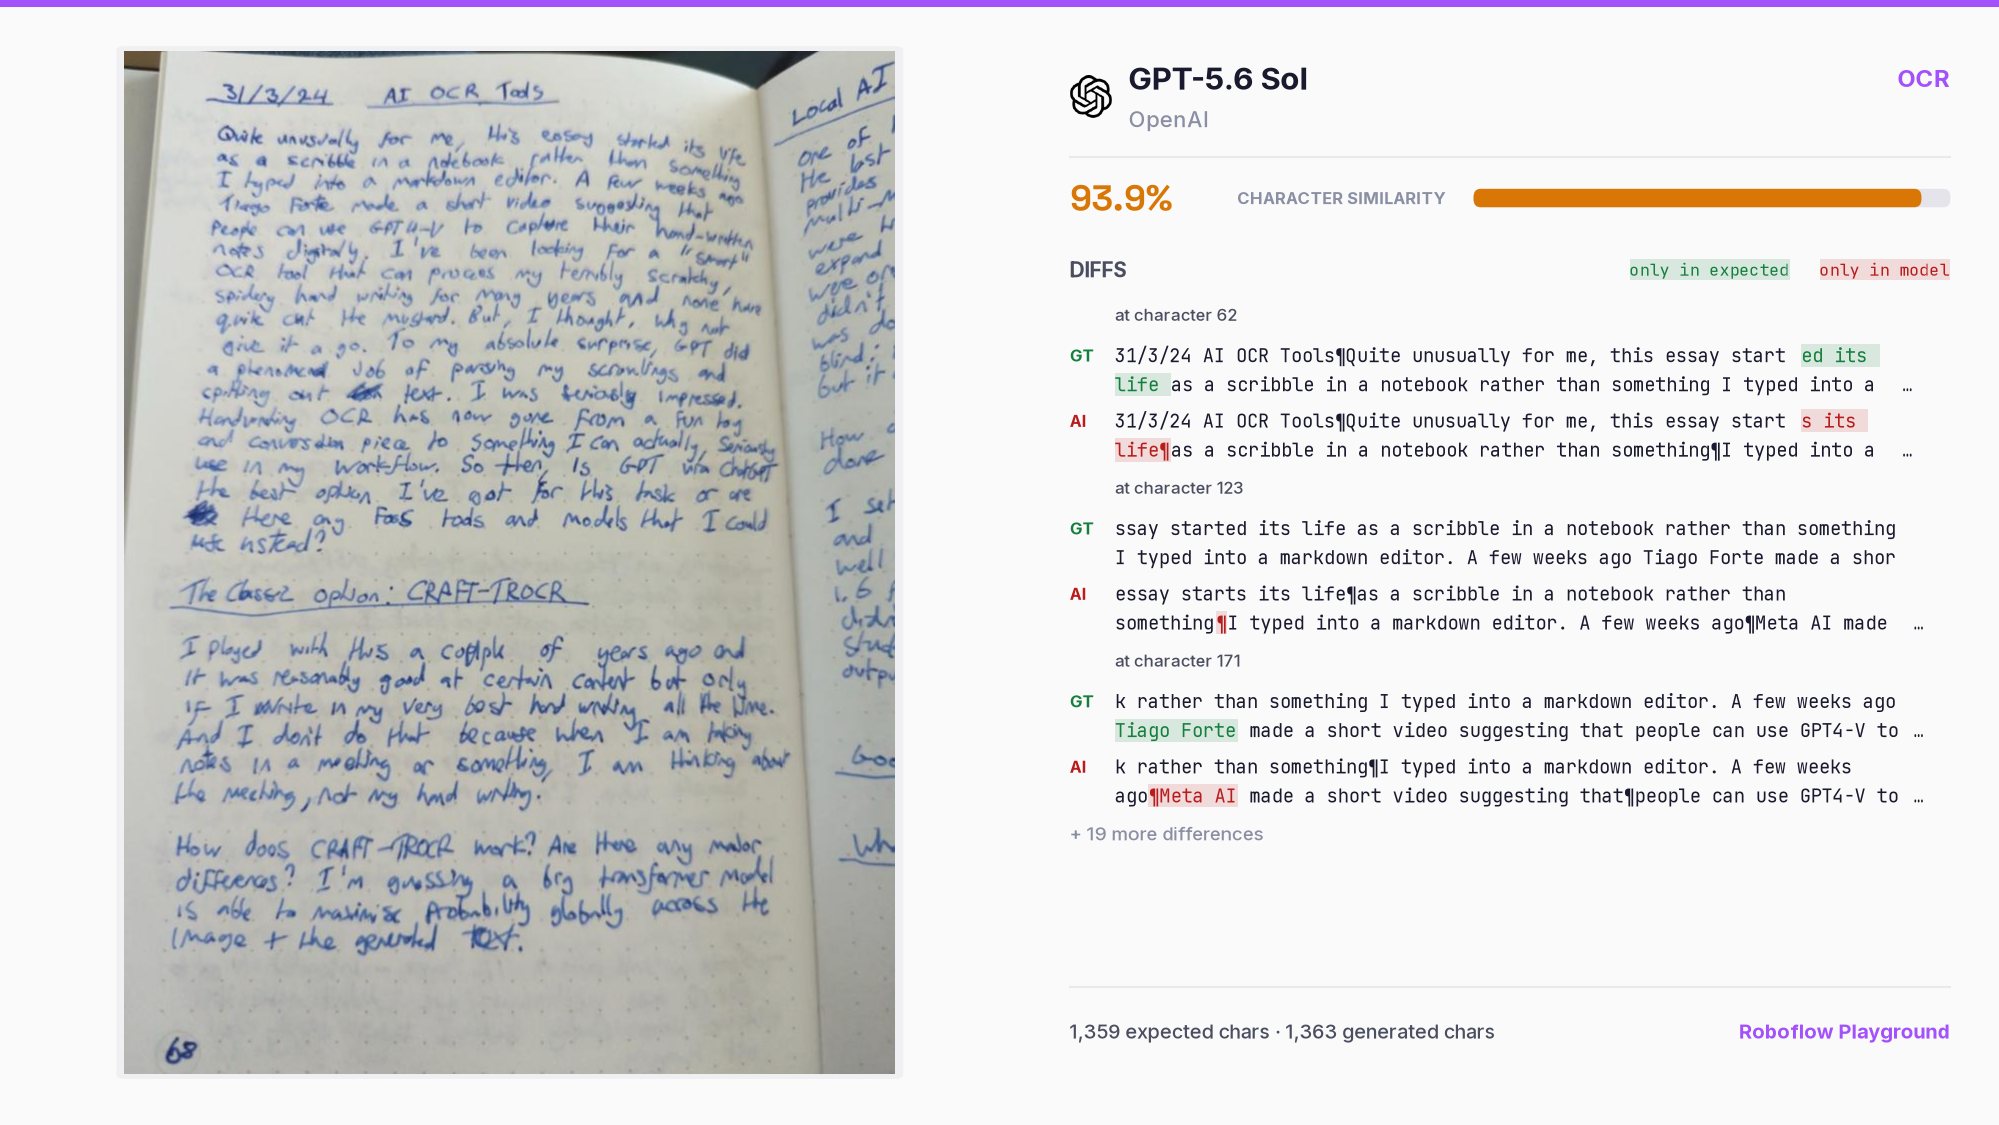
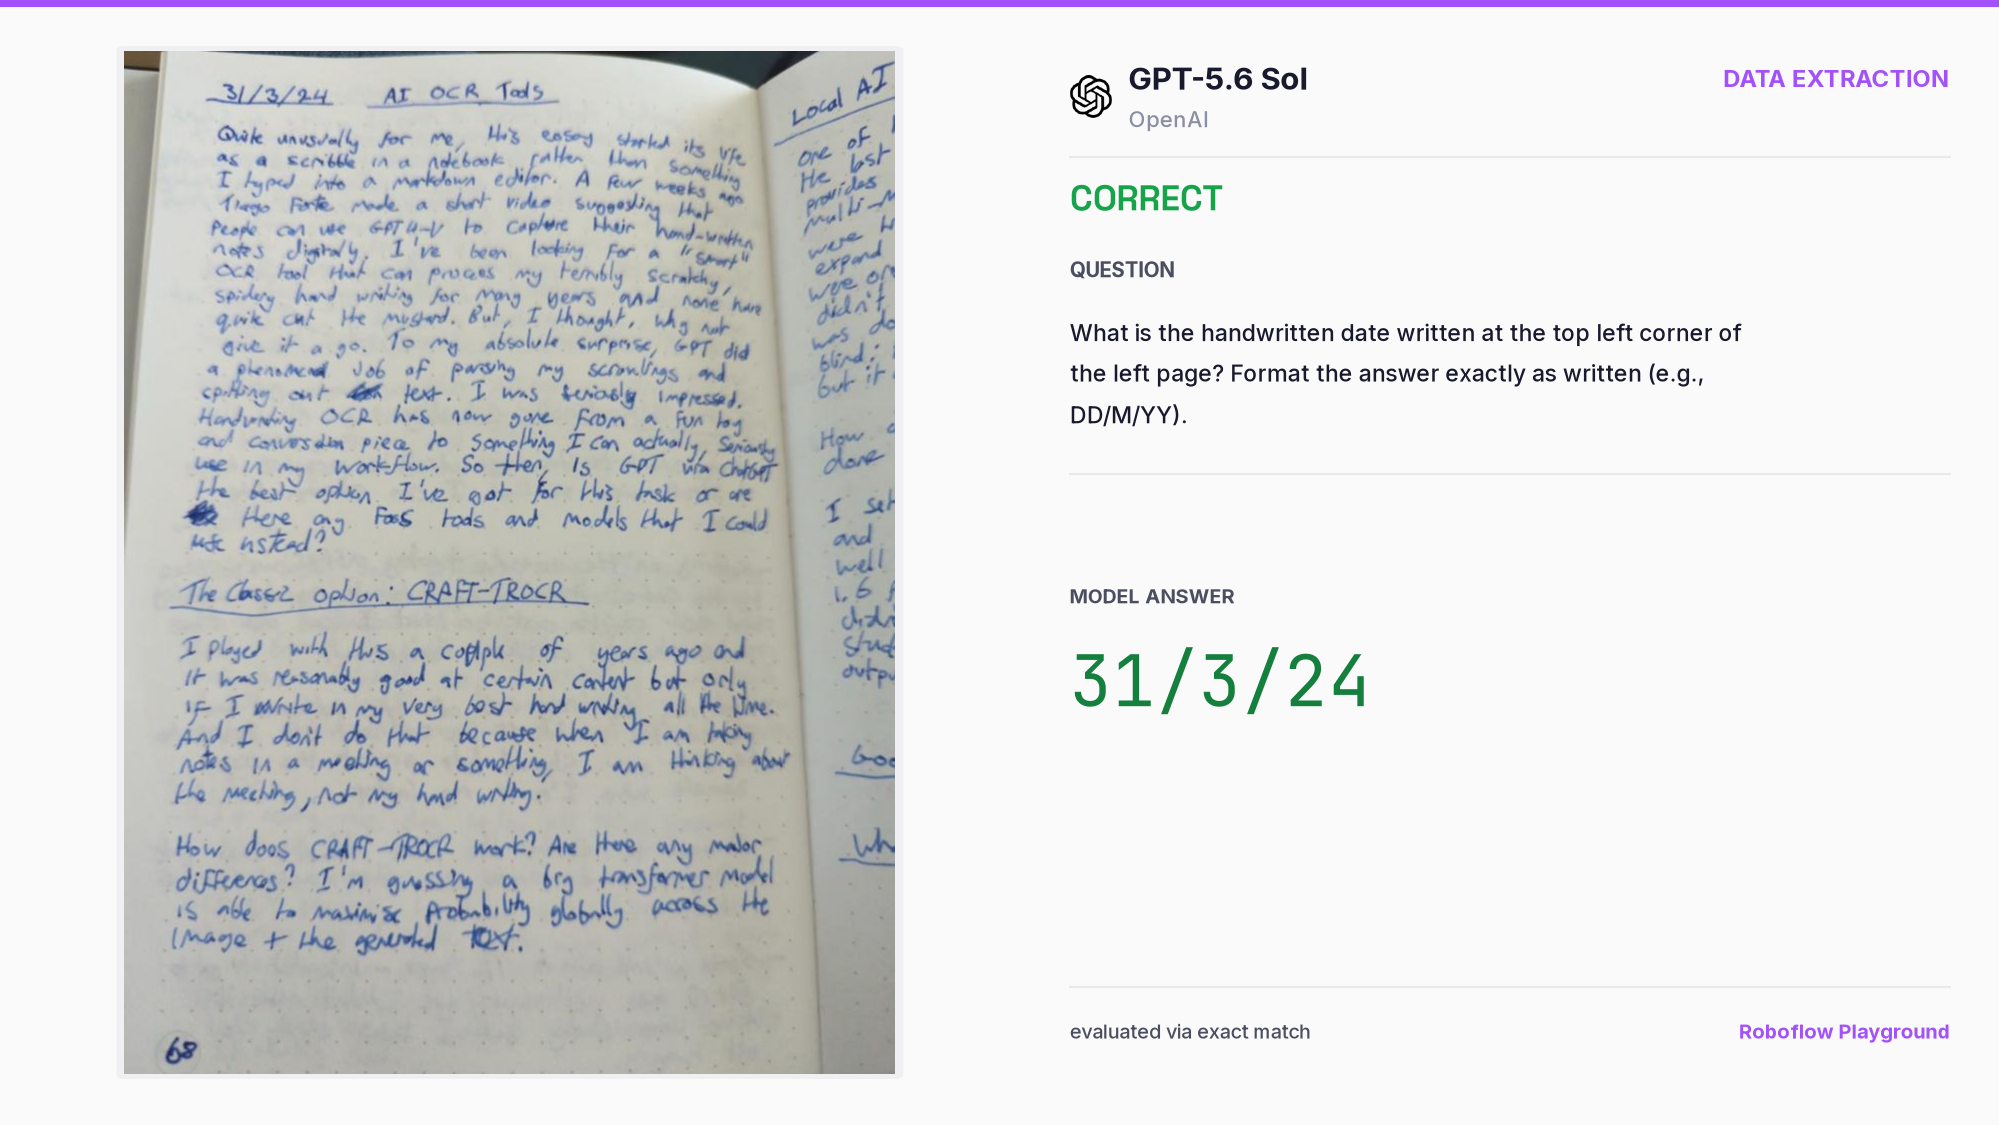
作为基准测试的一部分,我们将完整转录与定向提取区分开来。OCR 要求模型转录所有可见文本,而文本提取要求提取特定信息。Sol 在两种情况下对手写笔记都表现良好,一次生成了完整转录,另一次提取了要求的日期。
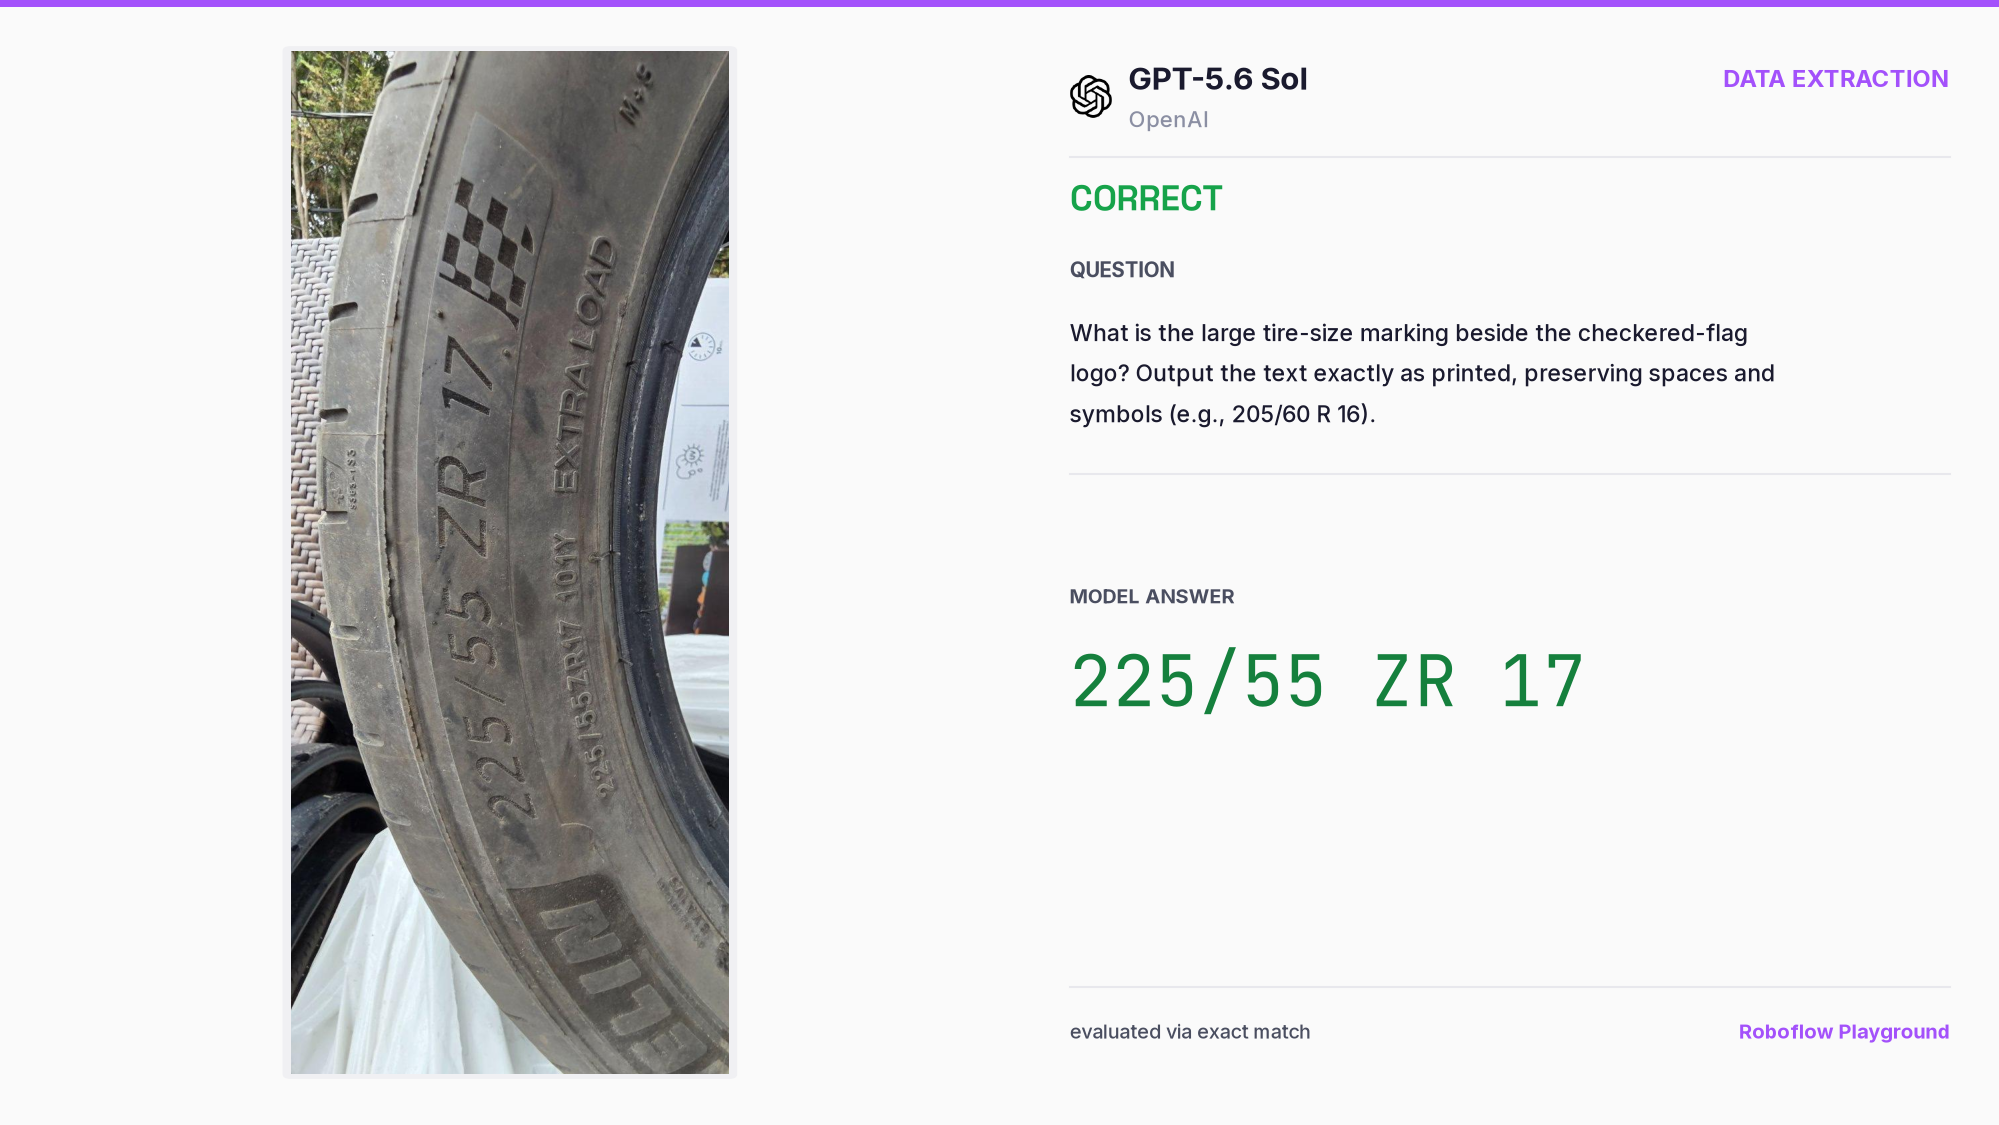
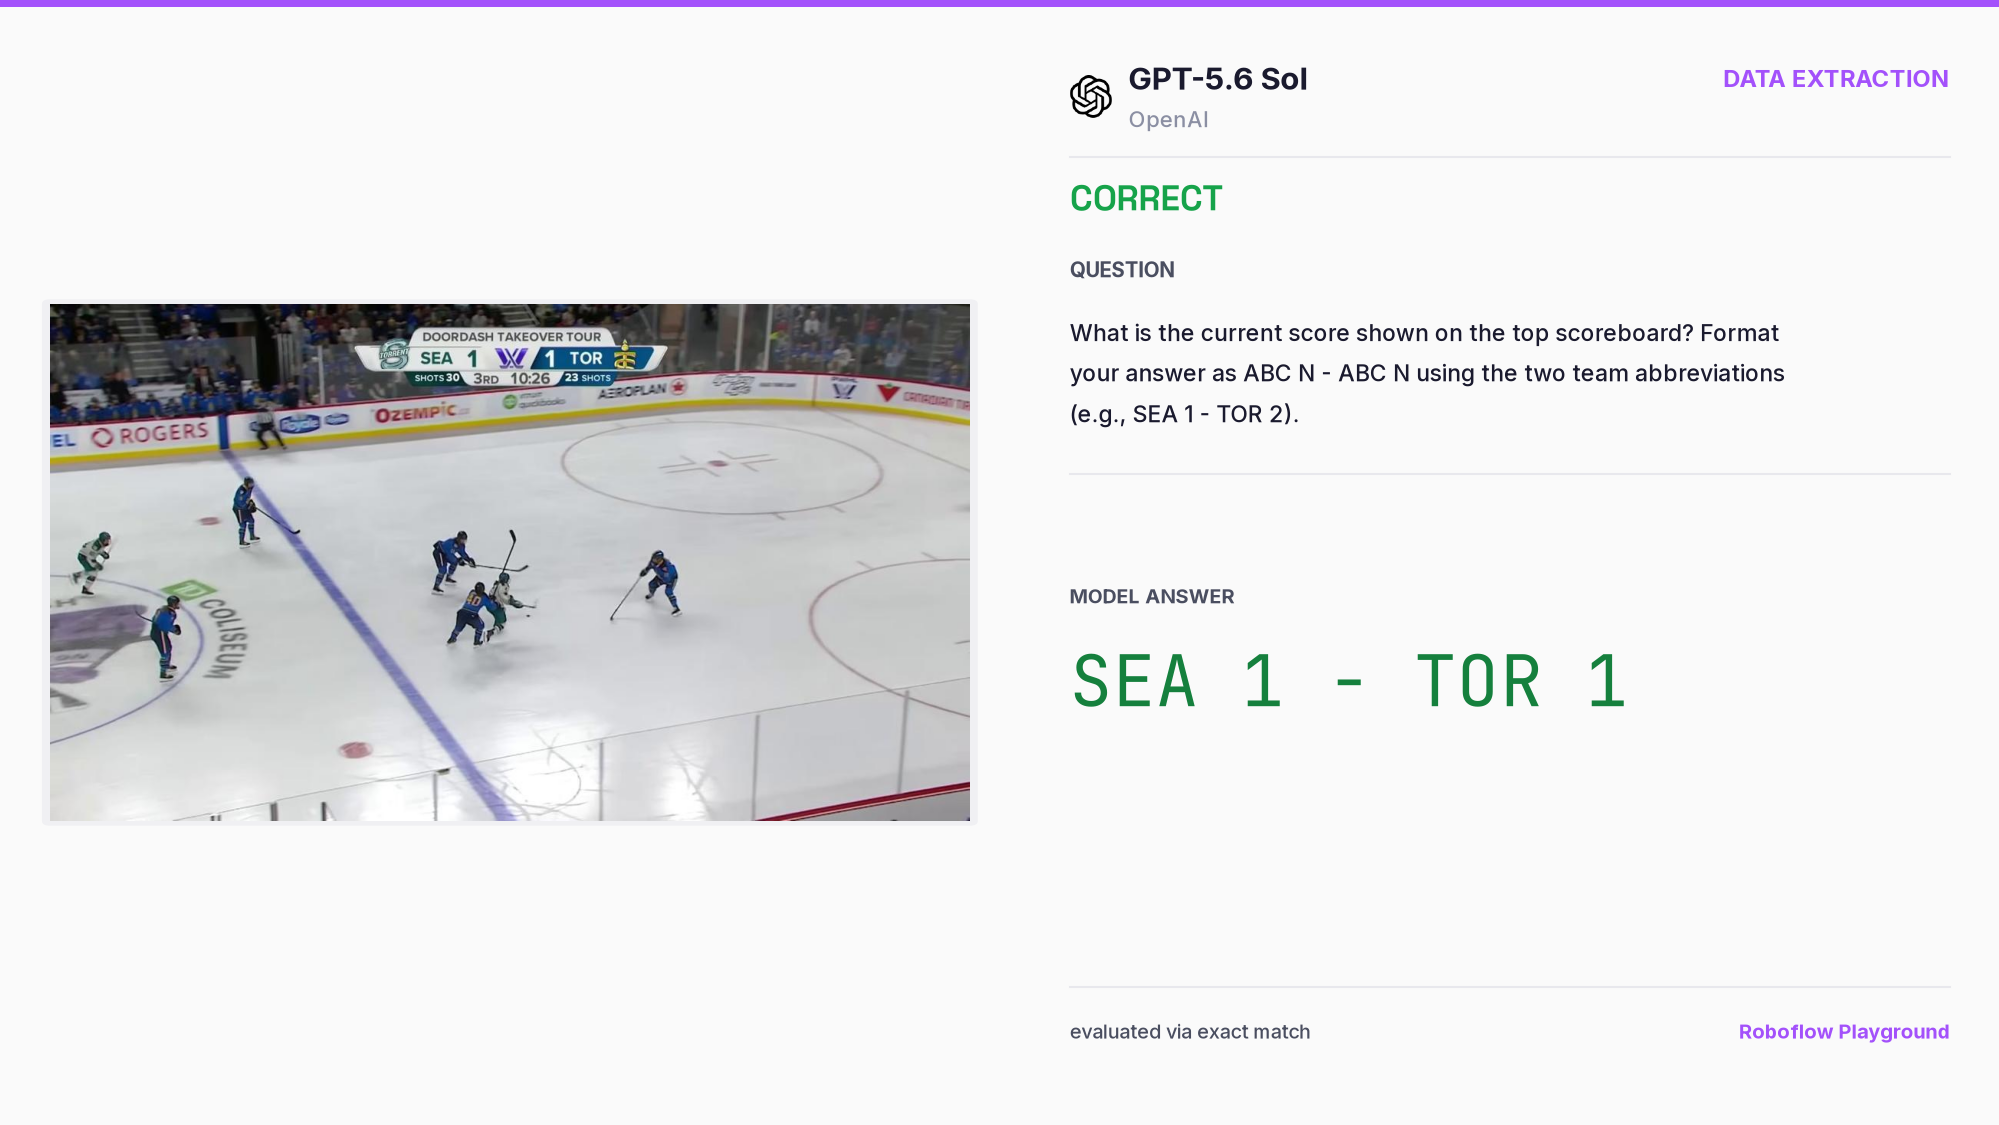
Sol 在复杂视觉场景中嵌入的文本上表现良好。它读取了印在脏旧轮胎曲面上的轮胎尺寸序列。在另一个示例中,它从曲棍球转播中提取了实时比分,并以要求的格式返回答案,同时测试了视觉阅读和指令遵循能力。
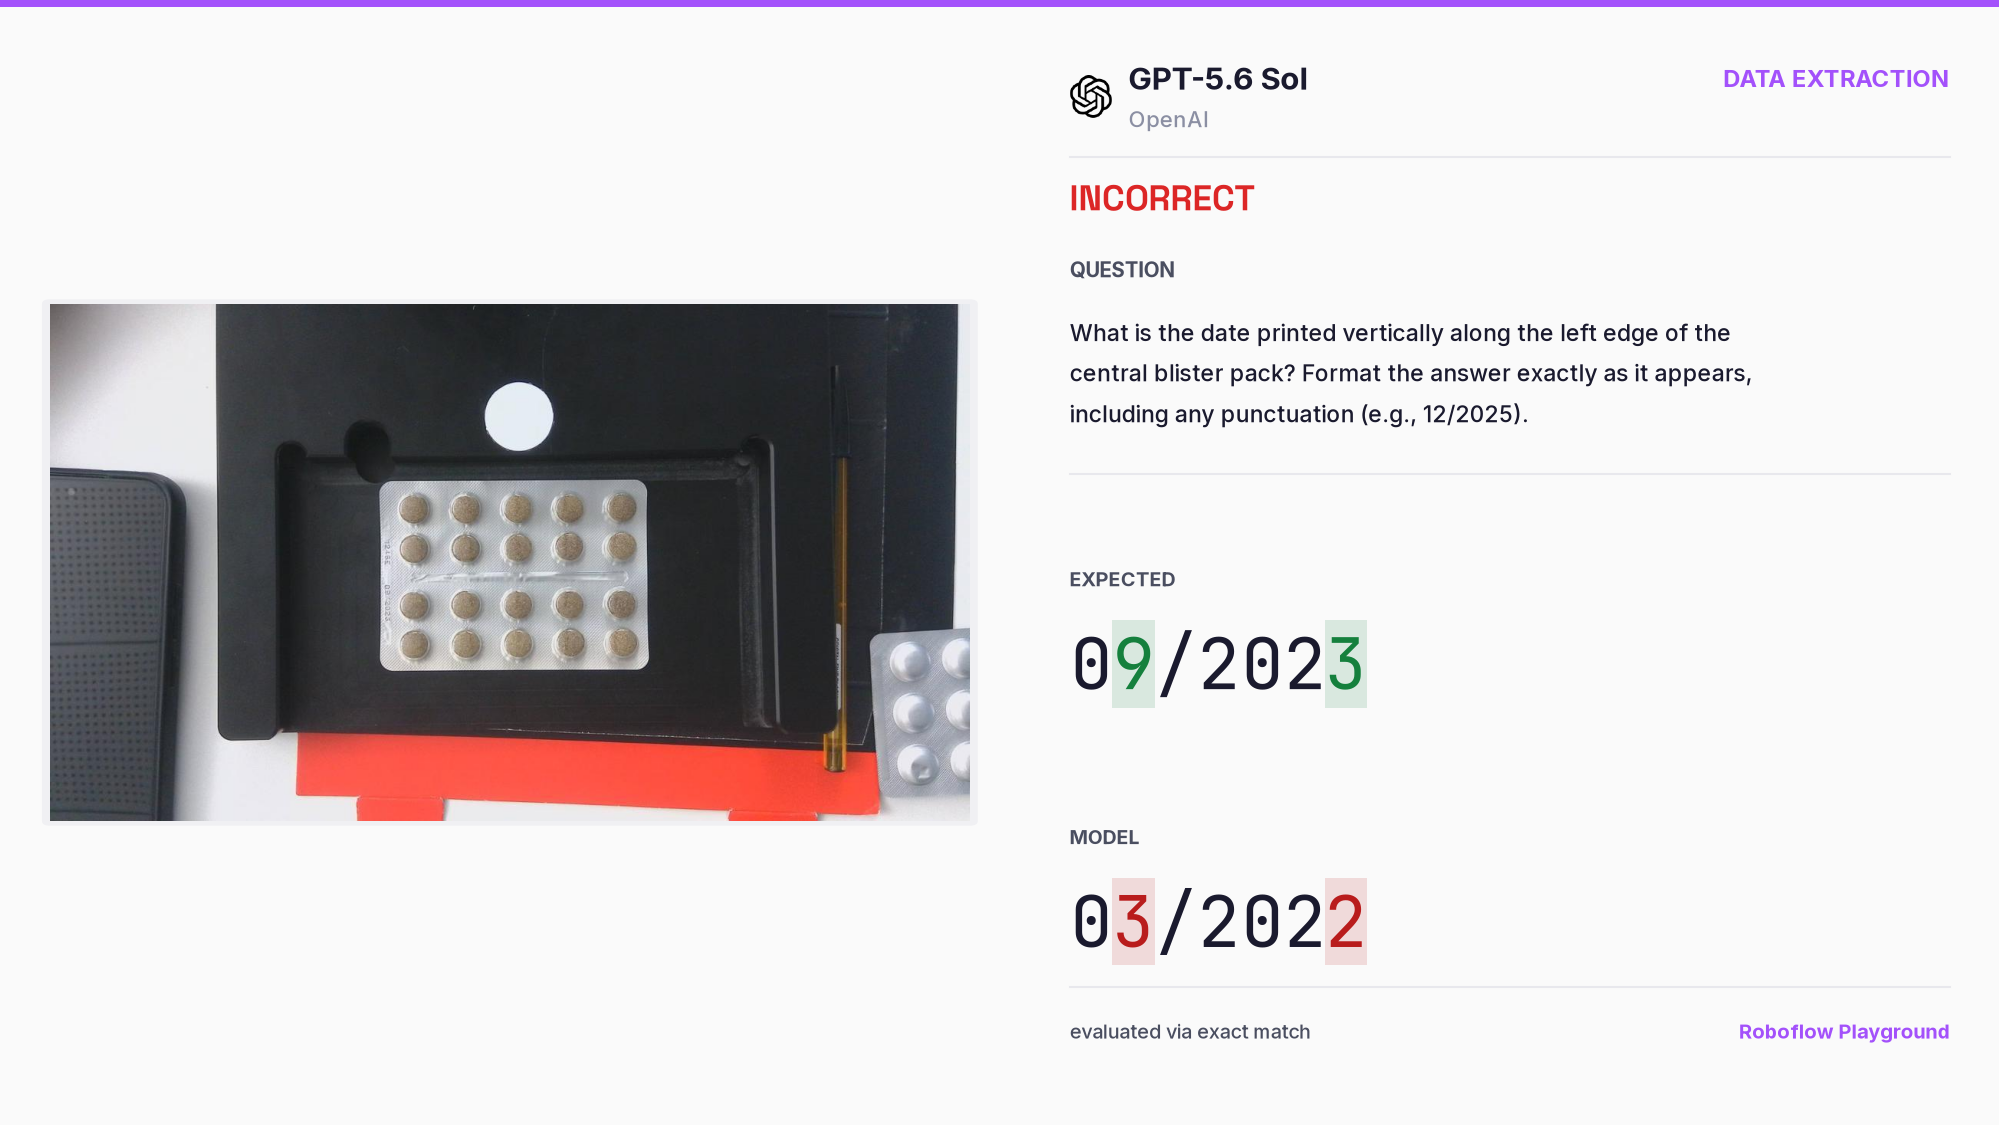
一些看似简单的提取任务仍然失败。Sol 无法读取印在泡罩包装上的有效期。文本小、垂直、对比度低,并受反光影响,这可能解释了错误的原因。
权衡取舍
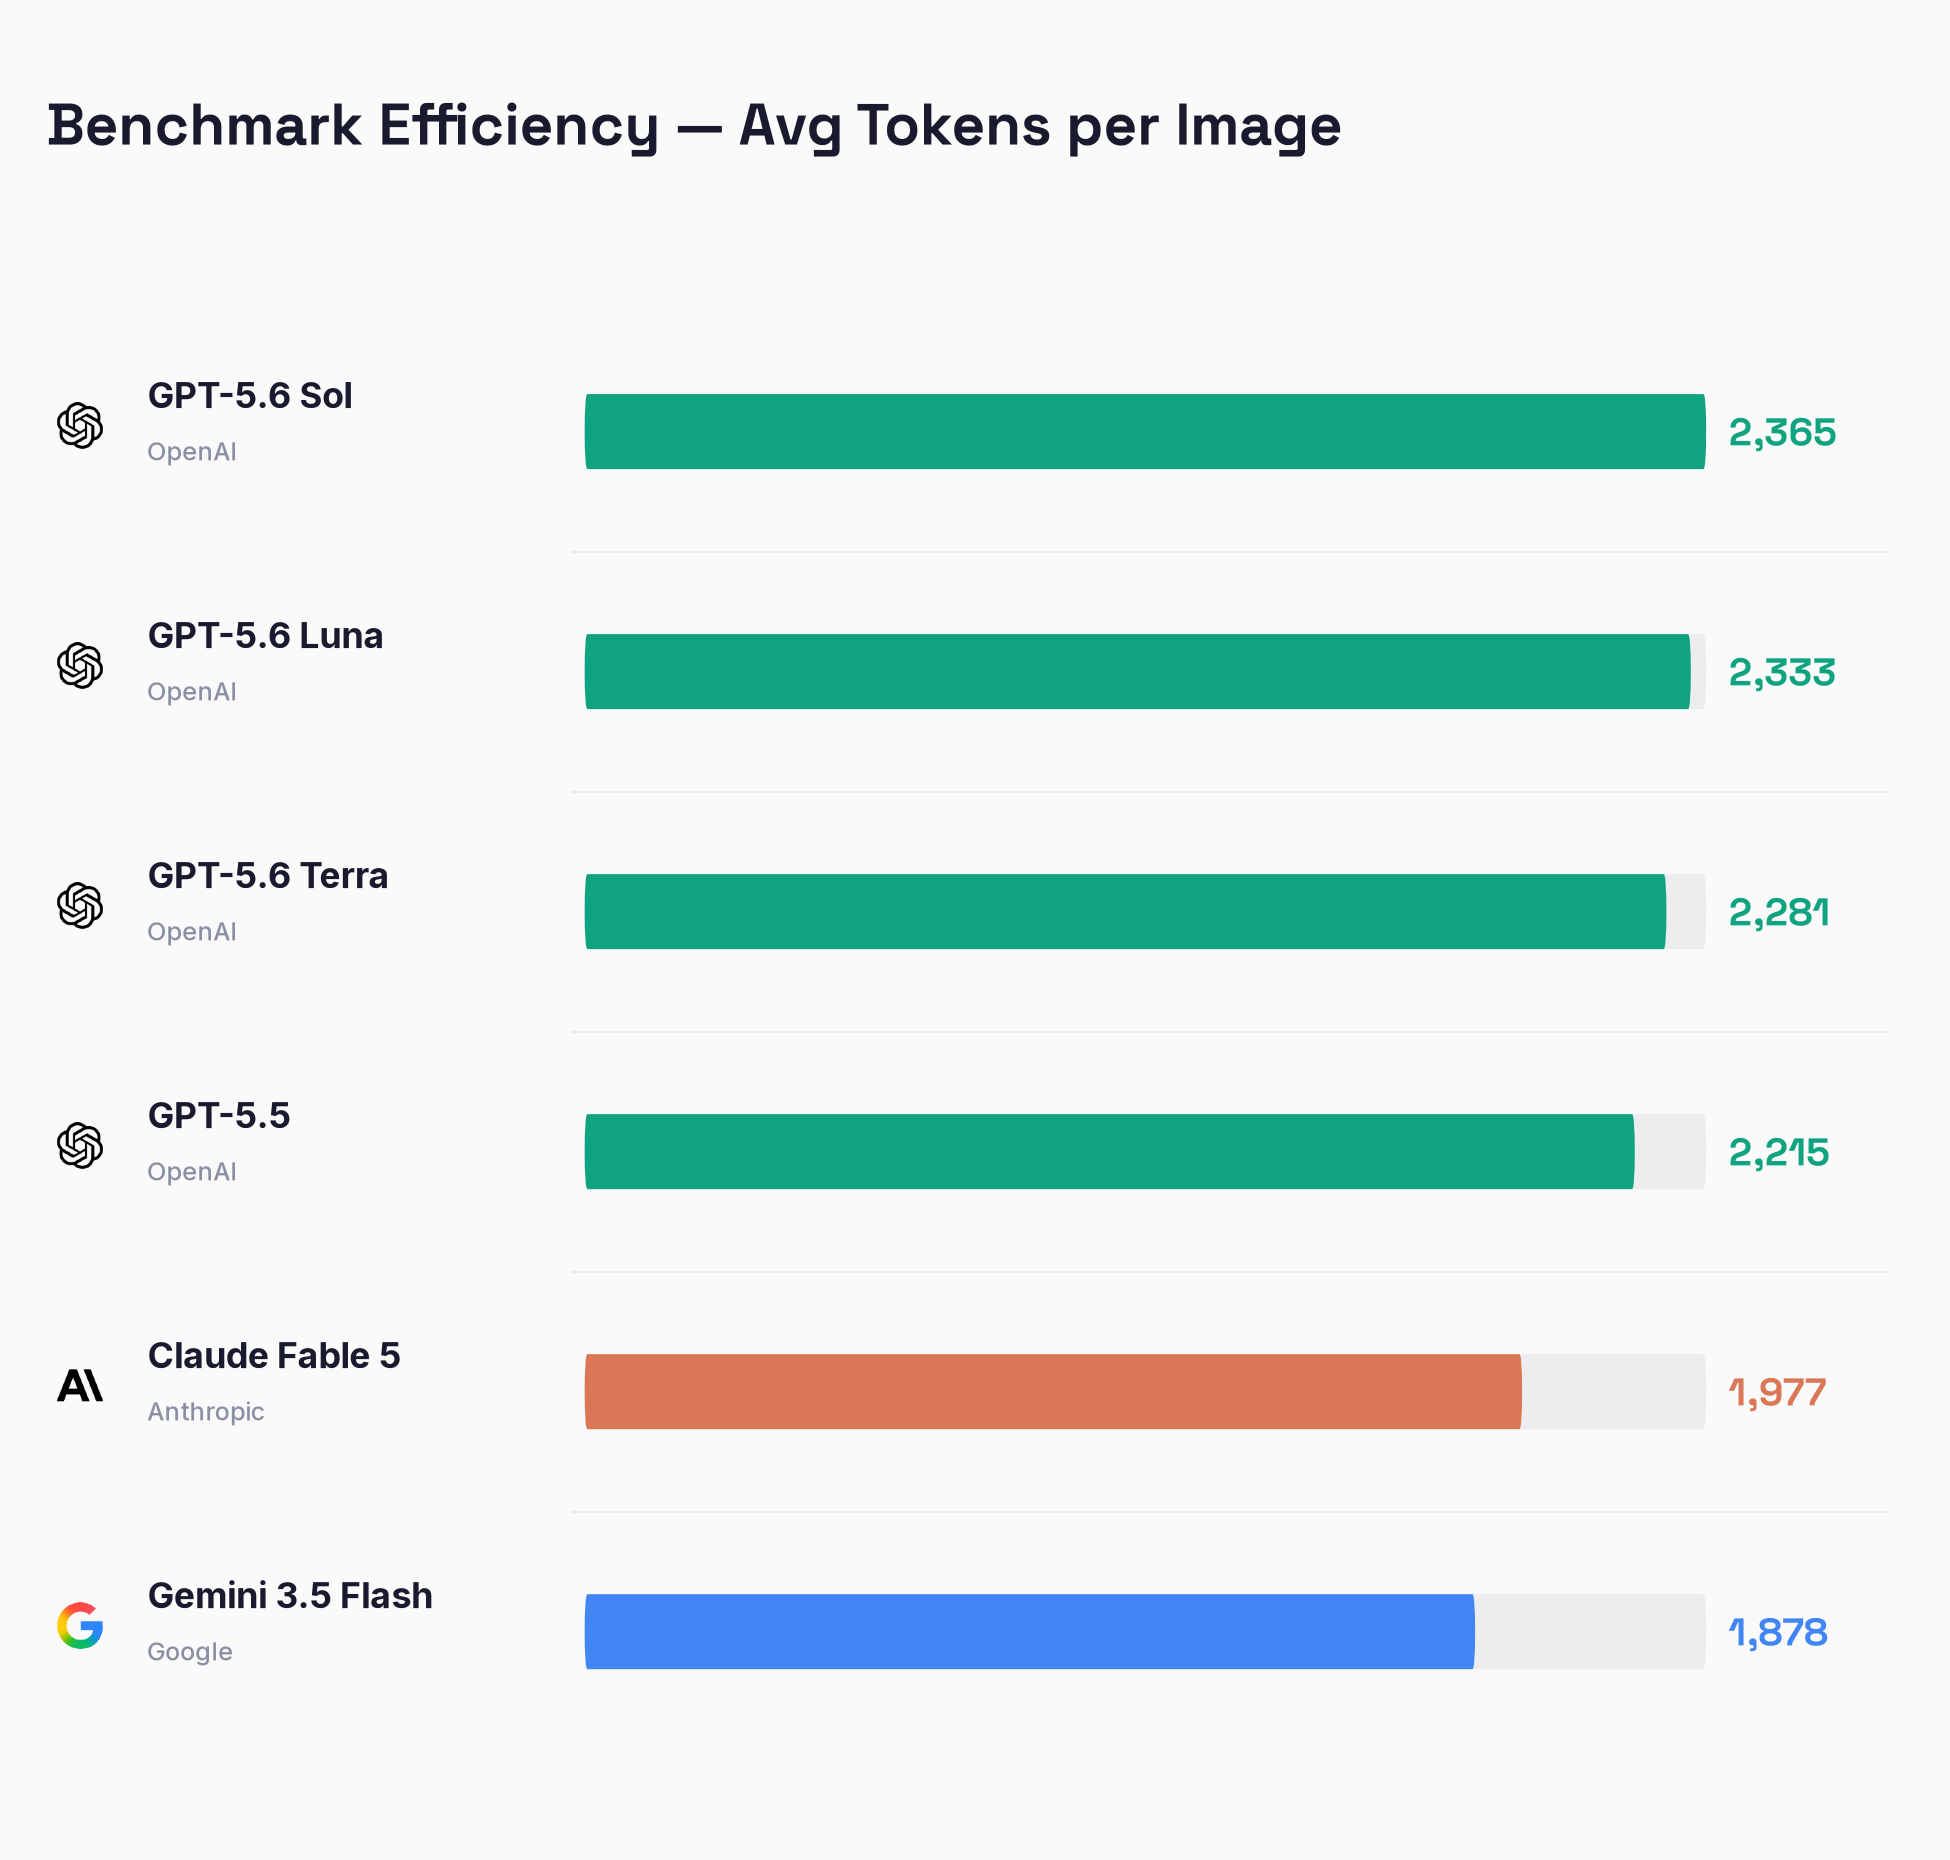
视觉能力的提升伴随着整个 GPT-5.6 系列更高的 token 使用量。这种差异在小型测试中影响不大,但在大规模应用中变得更加重要,因为 token 量直接增加处理成本。
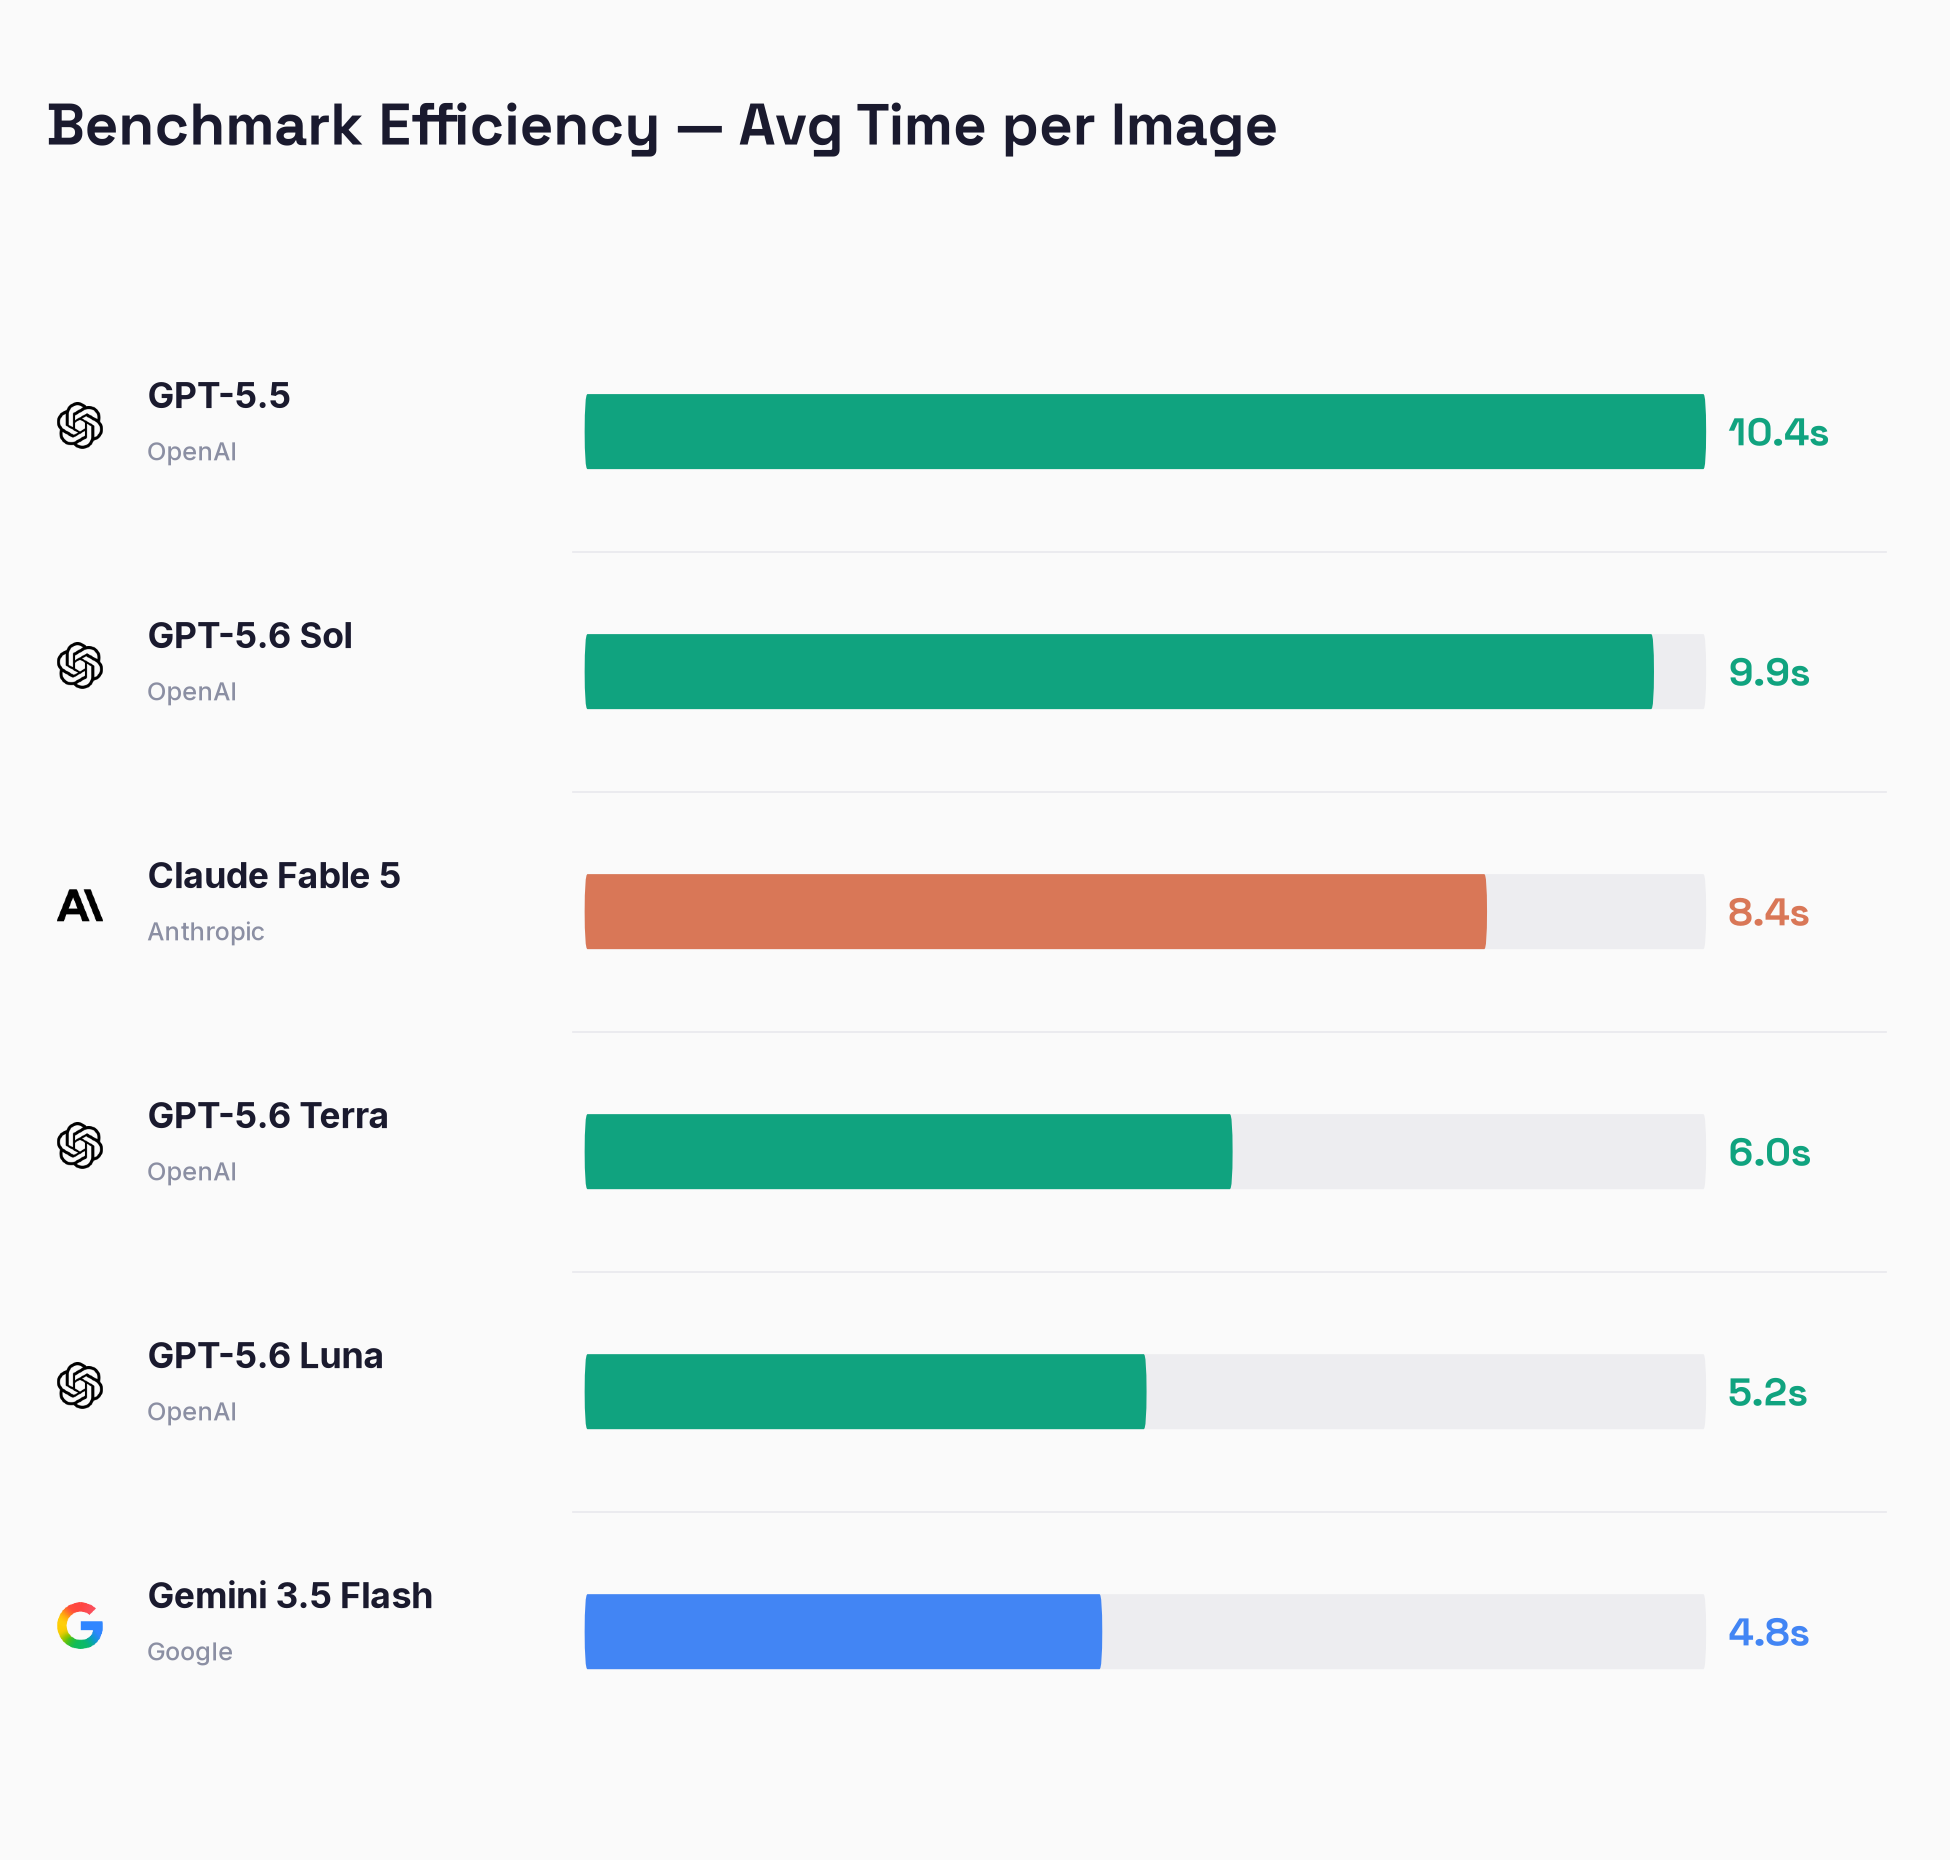
在我们的基准测试中,Sol 平均每张图像需要接近 10 秒。Terra 将其减少到约 6 秒,而 Luna 在略超 5 秒内完成。Luna 在该系列中提供了最强的延迟-质量平衡,速度接近 Gemini 3.5 Flash,同时在检测和计数方面仍优于 GPT-5.5。
在我们的基准测试中,Sol 每张图像大约花费 2.5 美分,成为仅次于 Claude Fable 5 的第二昂贵模型。Terra 将平均成本降低到每张约 1 美分,而 Luna 每张成本低于 0.5 美分。
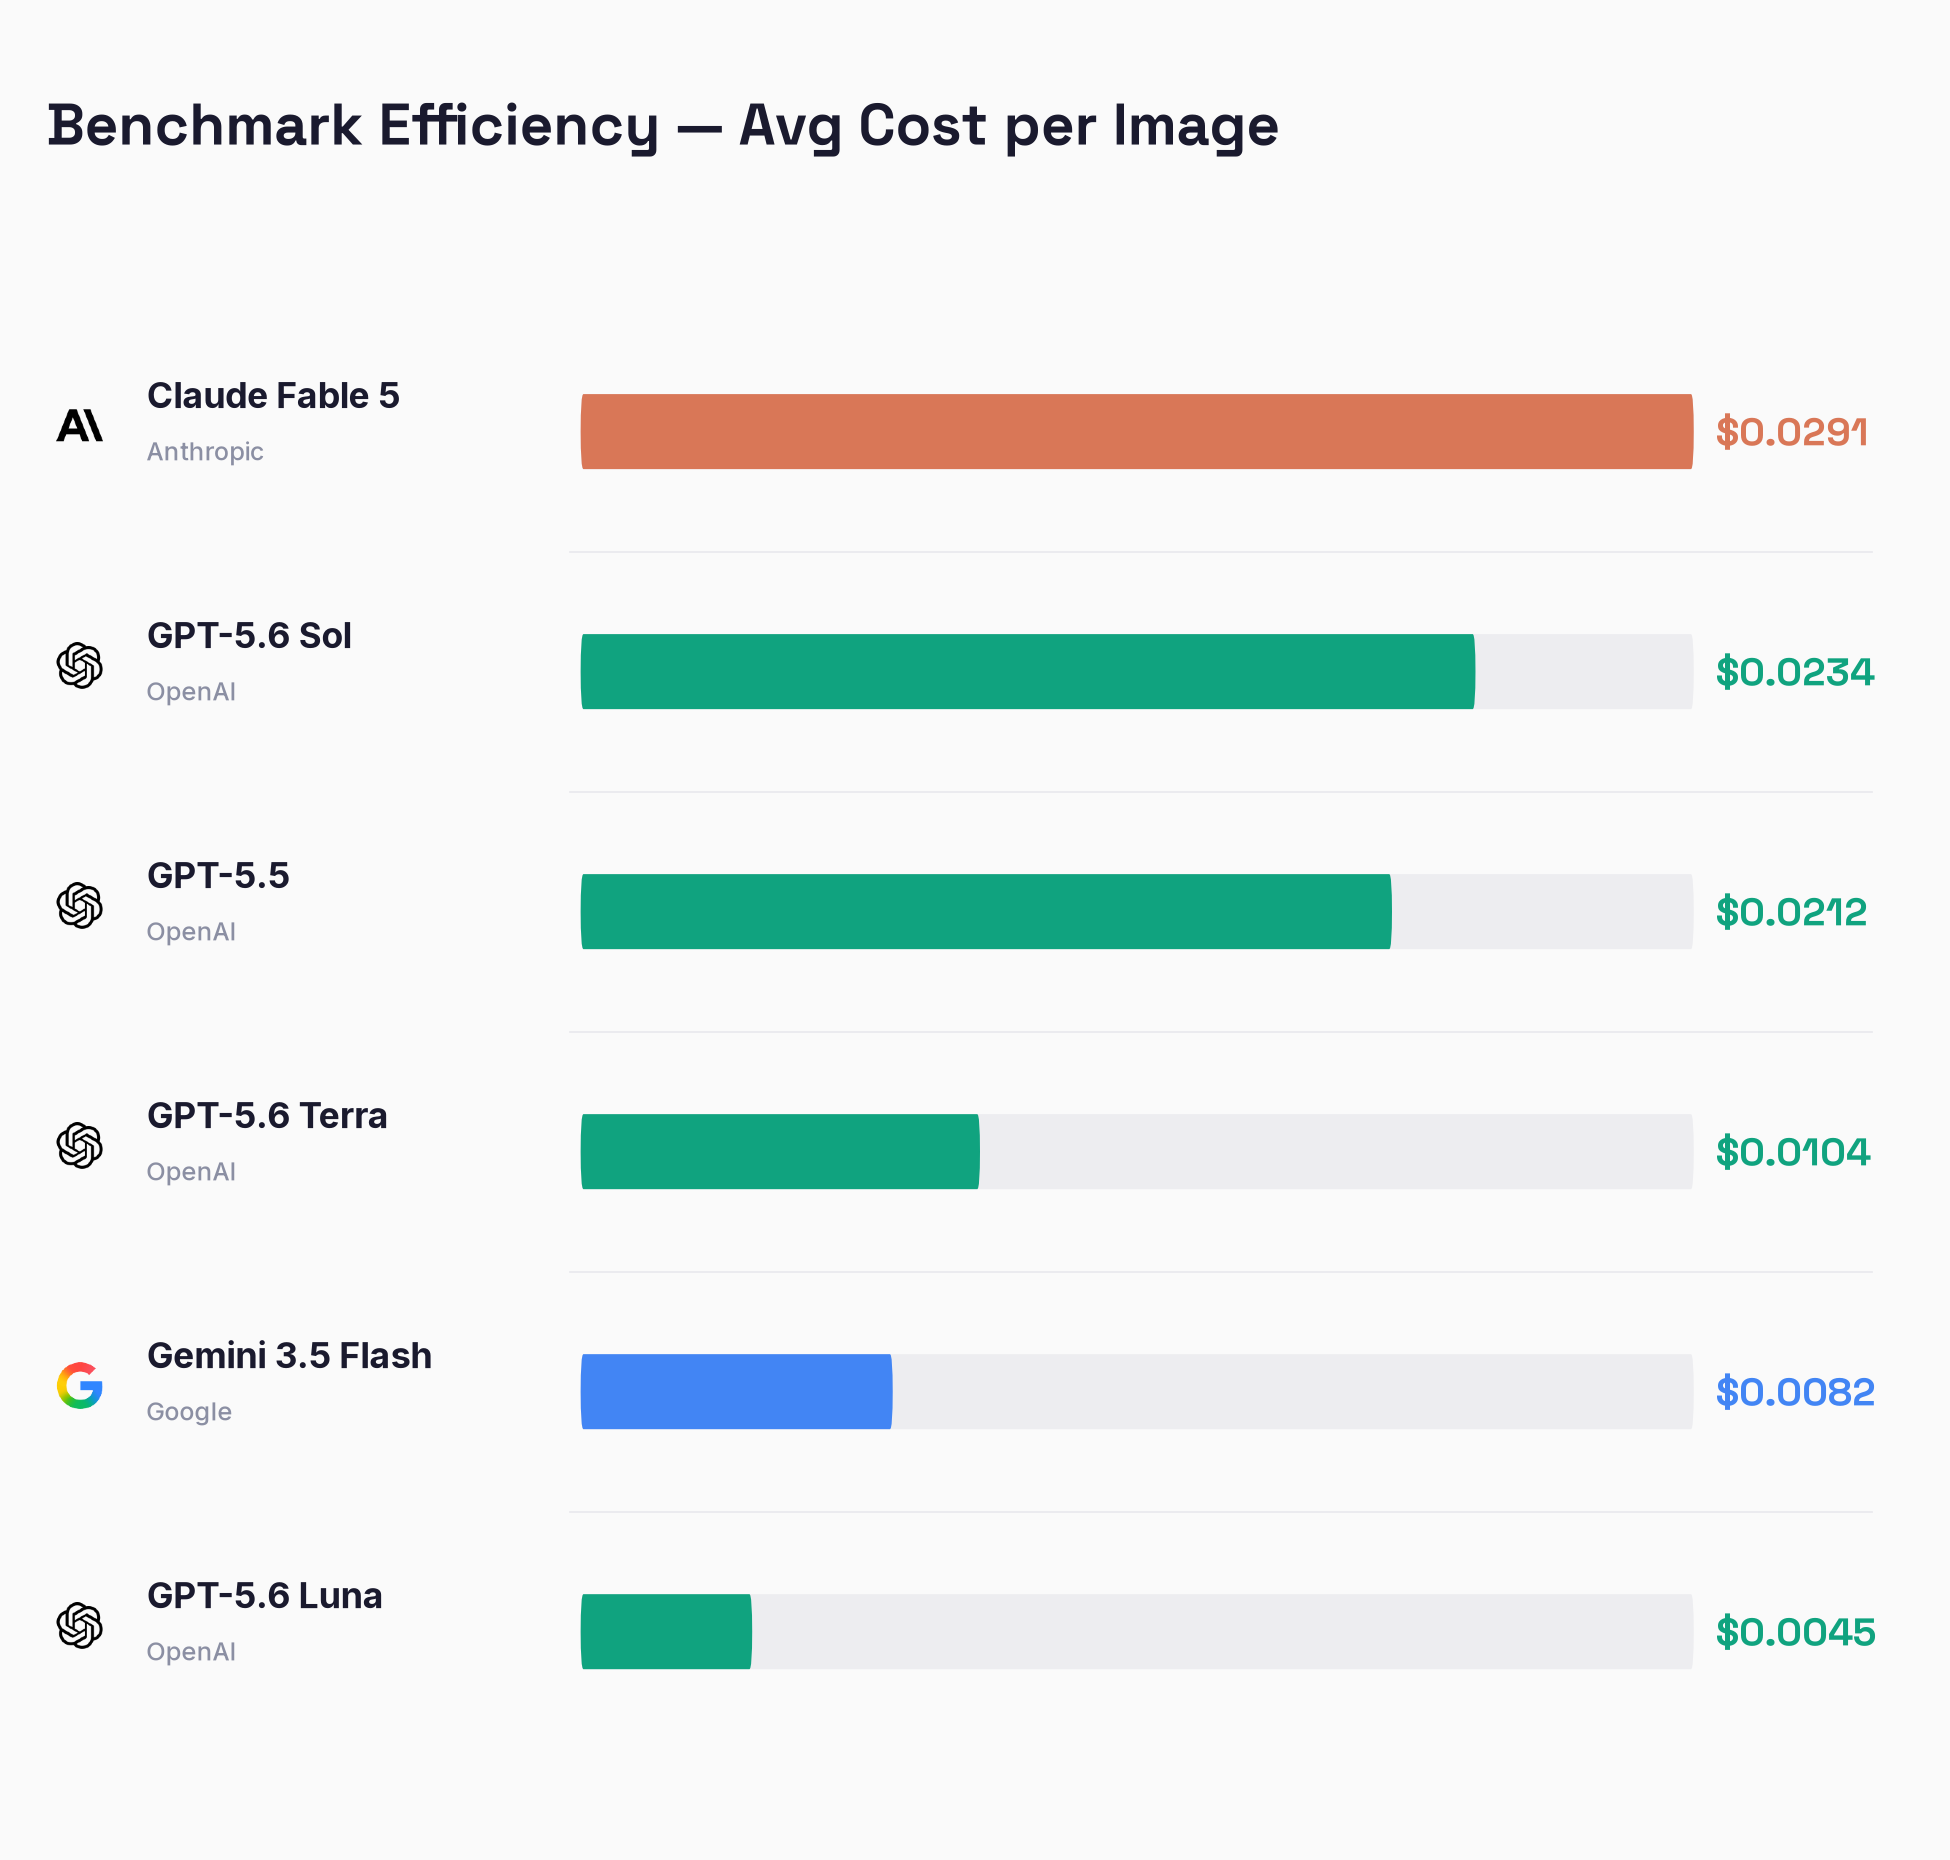
Gemini 3.5 Flash 每张图像 0.8 美分,比 Sol 便宜得多,同时仍然领先于我们的检测和计数基准。这使其成为数据密集型工作负载的强有力选择,因为在这种负载中,成本随着大批量图像而增长。Roboflow Playground 允许你在相同任务上测试 Sol、Terra 和 Luna,以及与 Claude Fable 5、Gemini 3.5 Flash 和其他 VLM 进行比较。
要点
借助 GPT-5.6,OpenAI 比以往更接近领先的 VLM。检测从弱项变成了可用能力,计数在整个模型系列中都有所改进。
仍然存在明显的限制。在我们的基准测试中,Gemini 3.5 Flash 仍然是高吞吐检测和计数的更好实际选择,尤其是在其价格下。
GPT-5.6 表明 OpenAI 现在更加重视视觉。Sol 仍然存在缺陷,尤其是在成本、延迟和一些不稳定的检测案例方面,但进步不容忽视。对于智能体、屏幕理解、文档工作流和视觉推理,此次发布使 OpenAI 成为比以往更强大的选择。
引用本文
在研究中使用以下条目引用这篇文章:
Piotr Skalski. (Jul 16, 2026). GPT 5.6 Sol is the best “vision” model OpenAI ever released. Roboflow Blog: https://blog.roboflow.com/openai-gpt-5-6/
作者
Piotr Skalski
ML Growth Engineer @ Roboflow | Owner @ github.com/SkalskiP/make-sense (2.4k stars) | Blogger @ skalskip.medium.com/ (4.5k followers)