Laya-CoreML
在 Apple Silicon 上进行开放权重的类型化决策。Core ML、Neural Engine、零生成 token。
PyPI · Hugging Face 权重 · 中文
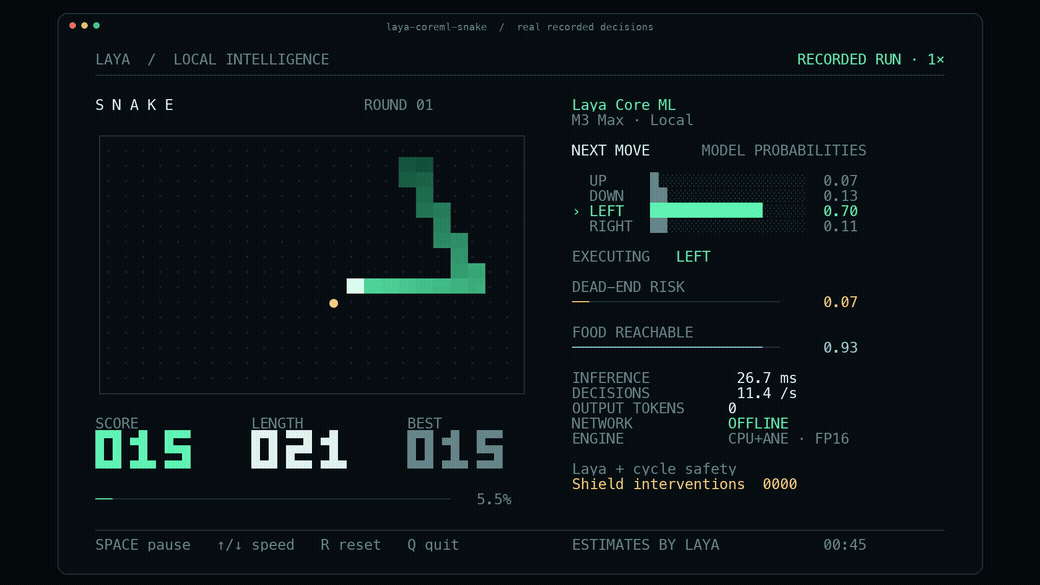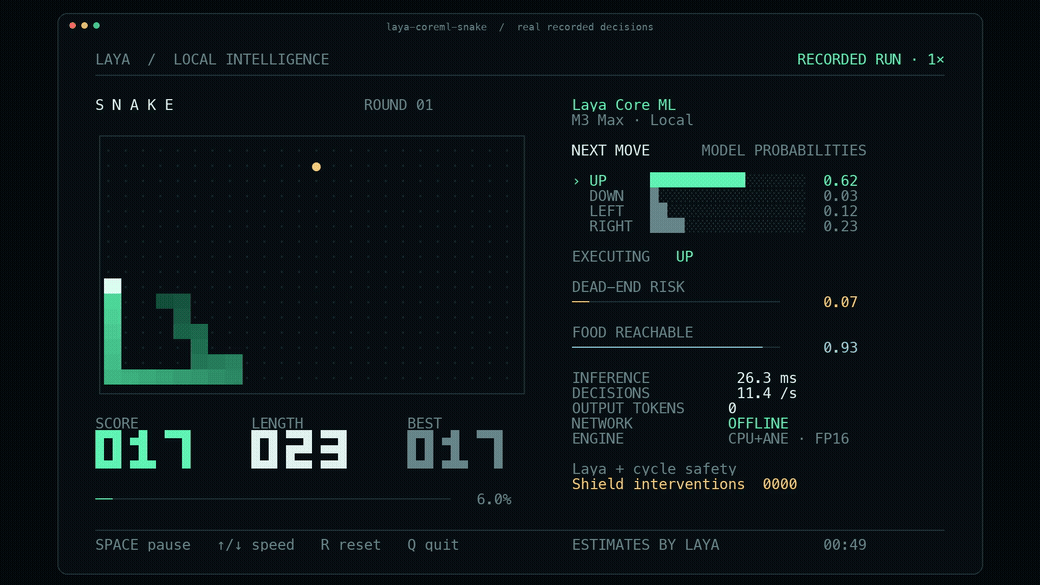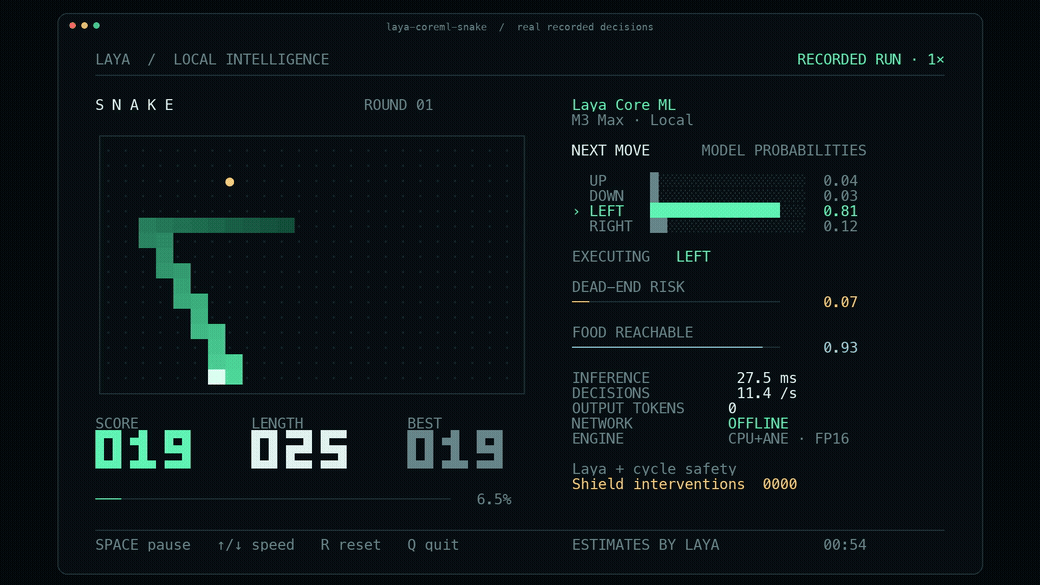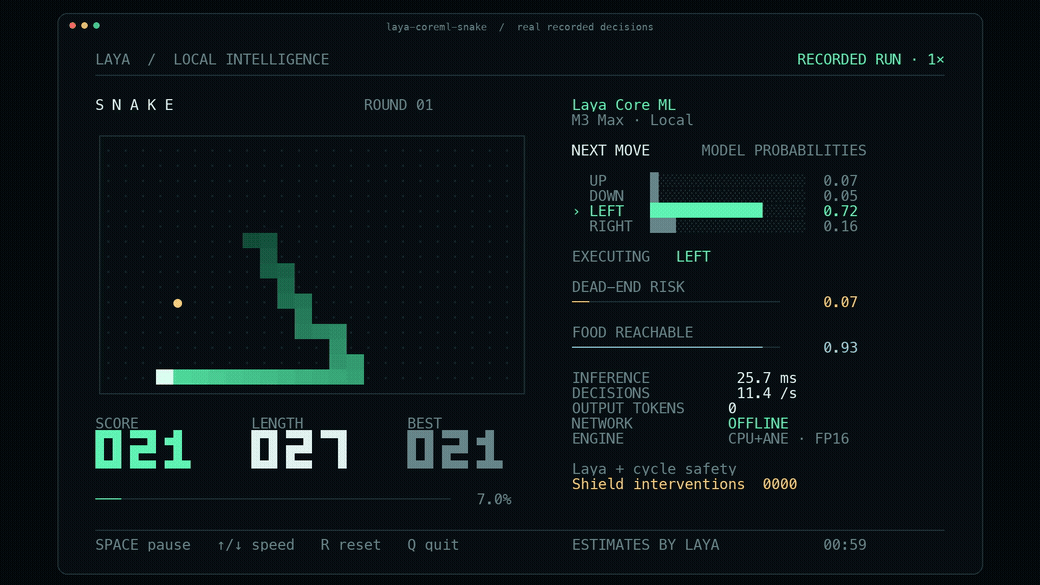
一个真实的 Laya 模型在本地玩贪吃蛇,概率、分数、长度、延迟和安全干预全部可见。GIF 以 1 倍速回放一段录制的 Core ML 运行。游戏使用显式规划器特征和可见的循环安全层。
完整的活跃贪吃蛇循环在三轮不设上限的 600 步对局中持续保持 49.1–50.0 次决策/秒,零死亡、两次安全干预。游戏循环计时与节流速率限制包含渲染串行化开销;终端绘制不计入。
**在 M3 Max 上使用 ANE FP16,一次简短多语言决策:P50 4.98 毫秒 / P95 5.31 毫秒。**同一实验测得每决策全系统能耗比编译版 MLX FP16 好 2.78 倍。单独验证的 W8 调色板变体达到 4.88 毫秒和 3.19 倍能耗改进。这些是单问题结果,并非完整的贪吃蛇帧时间;所要求的 10 倍改进未能实现。
运行演示
Apple Silicon · macOS 15+ · Python 3.11–3.13。
pip install 'laya-coreml[demo]'
hf download aac6fef/laya-multilingual-coreml-ane --local-dir models/snake
laya-coreml-snake --model ./models/snake
下载一次,之后即可离线游玩。推理不需要 PyTorch、Transformers 或 MLX。终端需要 104 列 × 35 行。空格暂停;↑/↓ 调速;R 重置;Q 退出。首次 Core ML 初始化可能需要数十秒。
操作、录制与视频导出 · 实测稳定决策速率 · 可分享的视频与录制来源
请求一次决策
pip install laya-coreml
import laya_coreml as laya

agent = laya.load("aac6fef/laya-multilingual-coreml-ane")
result = agent.predict(
    "The customer requests a refund of a duplicate payment.",
    {
        "refund": {
            "type": "noul",
            "instructions": "Does the customer request a refund?",
        }
    },
)
print(result["answers"]["refund"])
Laya 为 choice(选择)、序数 score(评分)和布尔 noul 问题返回概率。没有自回归解码,也没有需要解析的生成式 JSON。Hub 模型在初始化前下载;后续预测保持在本地。传入 local_files_only=True 以要求已有缓存,或加载本地目录。
ANE 包有 96 token 总限制,包括问题、选项和状态。更长的请求会引发容量错误。请使用 aac6fef/laya-multilingual-coreml 获取通用的 1024 token 模型。完整 API、模型选择与离线使用。
在 M3 Max 上实测
40 核 GPU、128 GiB 内存、macOS 27.2。一个 91 token 问题填充至 96,包括提示准备、分词、数组、同步推理、校准和格式化。加载与预热不计入。MLX 启用了编译、前缀缓存和形状分桶。每种实现各六个交替的 20 秒区块,共产生 65,598 次稳定调用。
| 指标 | 编译 MLX FP16 | Core ML ANE FP16 | Core ML ANE W8 |
|---|---|---|---|
| P50 / P95 | 6.94 / 7.39 ms | 4.98 / 5.31 ms | 4.88 / 5.23 ms |
| 平均系统功率估算 | 61.39 W | 30.75 W | 27.39 W |
| 每决策系统能耗 | 0.4288 J | 0.1540 J | 0.1344 J |
| 速度增益 | 1× | 1.39× | 1.42× |
| 系统能耗增益 | 1× | 2.78× | 3.19× |
能耗使用直接的 SMC PSTR 传感器读数,包含原始样本和明确的异常剔除。这是带有传感器与后台负载不确定性的估算。速度增益 × 平均功率比 = 能耗增益;把能耗再乘以速度会重复计算时间。W8 变体在保留 FP16 计算的同时压缩权重。它是近似的,其包体积缩减并非速度比率。
速度、能耗与硬件证据 · 原始测量数据。
可用检查点
| Hugging Face 包 | 默认引擎 | 容量 | 用途 |
|---|---|---|---|
| Laya 421M | CPU + GPU | 512 tokens | 原始英文模型 |
| Multilingual 322M | CPU + GPU | 1024 tokens | 通用多语言决策 |
| Typed Decisions 421M | CPU + GPU | 1024 tokens | 原始专用检查点 |
| Snake GPU | CPU + GPU | B3 / L64 | 批处理三个紧凑的游戏问题 |
| Multilingual ANE | CPU + ANE | B1 / L96 | 短决策,FP16 |
| Multilingual ANE W8 | CPU + ANE | B1 / L96 | 可选的近似调色板压缩 |
每个包都包含分词器/配置、模型卡、来源信息、校验和以及打包时验证。ANE 包还包含其所需的精确原始主机嵌入/动作张量。无需原始训练代码检出。
移植保真度与限制
三个通用 FP16 检查点在 189/189 个验证问题上与上游选定答案匹配,每个均通过 100 次重复调用。ANE FP16 L96 通过 59/59 个拟合问题,最大校准概率漂移为 0.002925;W8 在不变的 0.02 门限下通过同一子集,漂移为 0.014393。六比特和四比特实验未通过该门限,因此未发布权重。这些是转换保真度测试夹具,并非通用任务准确性的证明。
单独导出的 FP16 ANE L1024 图通过了完整的 63/63 测试,但在其串行路径上,实际的 1024 token 请求大约需要 91.7 毫秒。短 ANE 的结果并不能确立长上下文优势。一次 600 步配对贪吃蛇检查匹配 600/600 个动作,零死亡且零护盾干预;当前 ANE 适配器的三次顺序调用无法确立相对编译 MLX 的一致全游戏加速。
普通的 SDPA Core ML 导出与 ANE 图是不同的实现。在无约束 RangeDim GPU 形状未通过本地保真度检查后,普通导出默认使用 CPU+GPU。仅更改其设备设置无法复现 ANE 结果。ANE 重写使用 BC1L 激活、1×1 投影和逐头注意力;其方案和一份单独的 Instruments 轨迹佐证了 Neural Engine 的工作。CPU 仍负责输入/输出边界。
文档与可复现性
要自行导出,请安装 laya-coreml[convert] 并运行 laya-coreml convert laya-multilingual models/custom。ANE 研究转换、压缩和基准测试脚本位于 Git 检出中。推理 wheel 包含可移植运行时和可选的终端演示。
Apache-2.0 许可证。这是由 Convai Innovations 及贡献者开发的 Laya 的独立移植,基于 MLX 姊妹项目构建。并非 Convai Innovations 或 Apple 的官方发布。参见 NOTICE。